kafka basic
Tung Bui Thanh (TungDaDev)29 mins read
Nếu microservices là các thành phố thì Kafka là đường cao tốc nối chúng lại với nhau.
Tôi làm với Kafka cũng nhiều năm rồi, từ hồi tự dựng cluster 3 broker cho một startup nhỏ, tới lúc vận hành hệ thống xử lý hàng triệu events/giây trên production. Bài này gom lại những thứ tôi ước gì mình được biết ngay từ ngày đầu.
# kafka là gì?
Apache Kafka là một distributed event streaming platform. Nghe thì to tát, chứ bản chất nó là hệ thống cho phép bạn:
- Publish (ghi) và Subscribe (đọc) các luồng dữ liệu (events/messages)
- Store dữ liệu đó bền vững, có hỏng một máy cũng không mất
- Process dữ liệu ngay khi nó tới, hoặc đọc lại dữ liệu cũ để xử lý sau
Cứ hình dung Kafka là một commit log phân tán: cái gì đã ghi vào thì không sửa được (immutable), có thứ tự, và đọc lại lúc nào cũng được.
# why not RabbitMQ or Redis Pub/Sub?
Câu này tôi bị hỏi nhiều nhất. Trả lời ngắn gọn:
| Tiêu chí | Kafka | RabbitMQ | Redis Pub/Sub |
|---|---|---|---|
| Throughput | Hàng triệu msg/s | Hàng chục nghìn msg/s | Hàng trăm nghìn msg/s |
| Message Retention | Có (configurable) | Queue thường: không (consume xong là mất) | Không |
| Consumer Groups | Native support | Limited | Không |
| Replay Messages | Có | Queue thường: không | Không |
| Ordering Guarantee | Per-partition | Per-queue | Không |
| Use case chính | Event streaming, Log aggregation | Task queue, RPC | Real-time notifications |
Rule of thumb: cần một task queue kiểu fire-and-forget thì chọn RabbitMQ. Cần một event log cho nhiều service cùng đọc thì chọn Kafka.
Bảng trên so với queue truyền thống của RabbitMQ và Redis Pub/Sub. Ranh giới giờ đã mờ đi khá nhiều: RabbitMQ có thêm Streams (từ 3.9) lưu được message và đọc lại theo offset, Redis có Streams với consumer group. Ngược lại, Kafka 4.2 đưa share group (KIP-932, "Queues for Kafka") lên GA: nhiều consumer cùng xử lý một partition, ack từng message như task queue. Con số throughput trong bảng cũng chỉ là bậc độ lớn để hình dung, tuỳ phần cứng và cấu hình mà chênh nhau nhiều.
# kiến trúc kafka
# broker: trái tim của Kafka
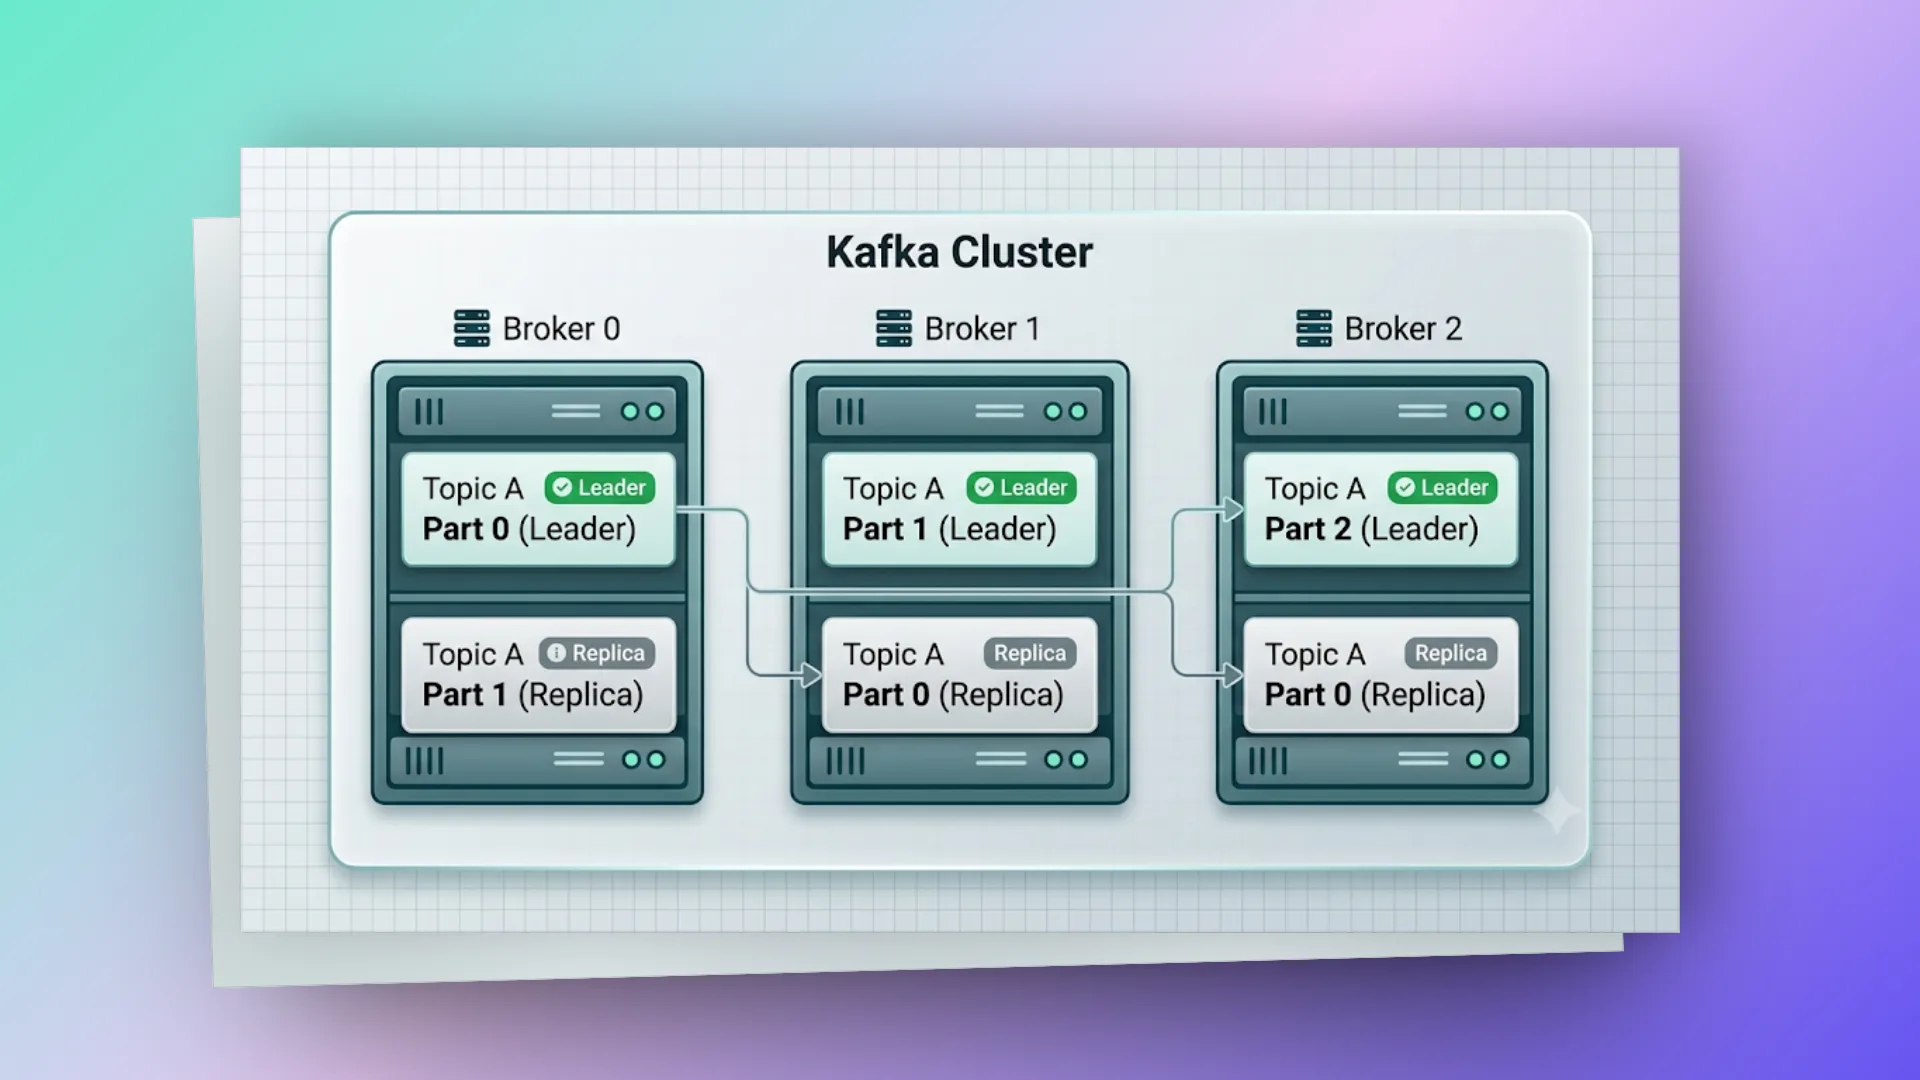
Broker là một Kafka server instance. Một Kafka cluster thường có nhiều broker (production thì tối thiểu 3). Mỗi broker lo mấy việc:
- Nhận messages từ producers
- Lưu trữ messages trên disk
- Phục vụ messages cho consumers
- Tham gia vào quá trình replication
# topic: kênh dữ liệu
Topic là một logical channel để gom messages lại theo chủ đề. Cứ nghĩ nó giống một bảng trong database, hay một folder trong file system.
Topic: "order-events"
├── Partition 0: [msg0, msg1, msg4, msg7, ...]
├── Partition 1: [msg2, msg3, msg5, msg8, ...]
└── Partition 2: [msg6, msg9, msg10, ...]
Naming convention tôi hay dùng:
<domain>.<entity>.<action>→payment.order.created- Hoặc đơn giản:
<entity>-events→order-events
# partition: chỗ quyết định Kafka scale được tới đâu
Nếu chỉ nhớ một khái niệm thì nhớ cái này. Mỗi topic được chia thành nhiều partition, và Kafka scale ngang (horizontally) chính nhờ chia partition.
Sao partition lại quan trọng?
- Parallelism: mỗi partition có thể giao cho một consumer riêng đọc
- Ordering: messages trong cùng một partition luôn giữ đúng thứ tự (FIFO)
- Distribution: các partition được rải đều lên các broker
Bao nhiêu partition là đủ?
Công thức tôi hay dùng:
num_partitions = max(T/P, T/C)

Trong đó:
- T = target throughput (msg/s)
- P = throughput mỗi producer có thể đạt trên 1 partition
- C = throughput mỗi consumer có thể đạt trên 1 partition
Thực tế thì đa số use case cứ bắt đầu với 6-12 partitions là ổn. Cần thì tăng lên, nhưng nhớ là không giảm xuống được. Tăng cũng có giá: công thức hash(key) % num_partitions đổi mẫu số, nên sau khi tăng thì một key có thể rơi sang partition khác, thứ tự theo key bị xáo trong lúc chuyển tiếp.
# offset: cái bookmark của consumer
Mỗi message trong một partition có một offset, là số nguyên tăng dần bắt đầu từ 0. Consumer nhìn offset để biết mình đã đọc tới đâu.
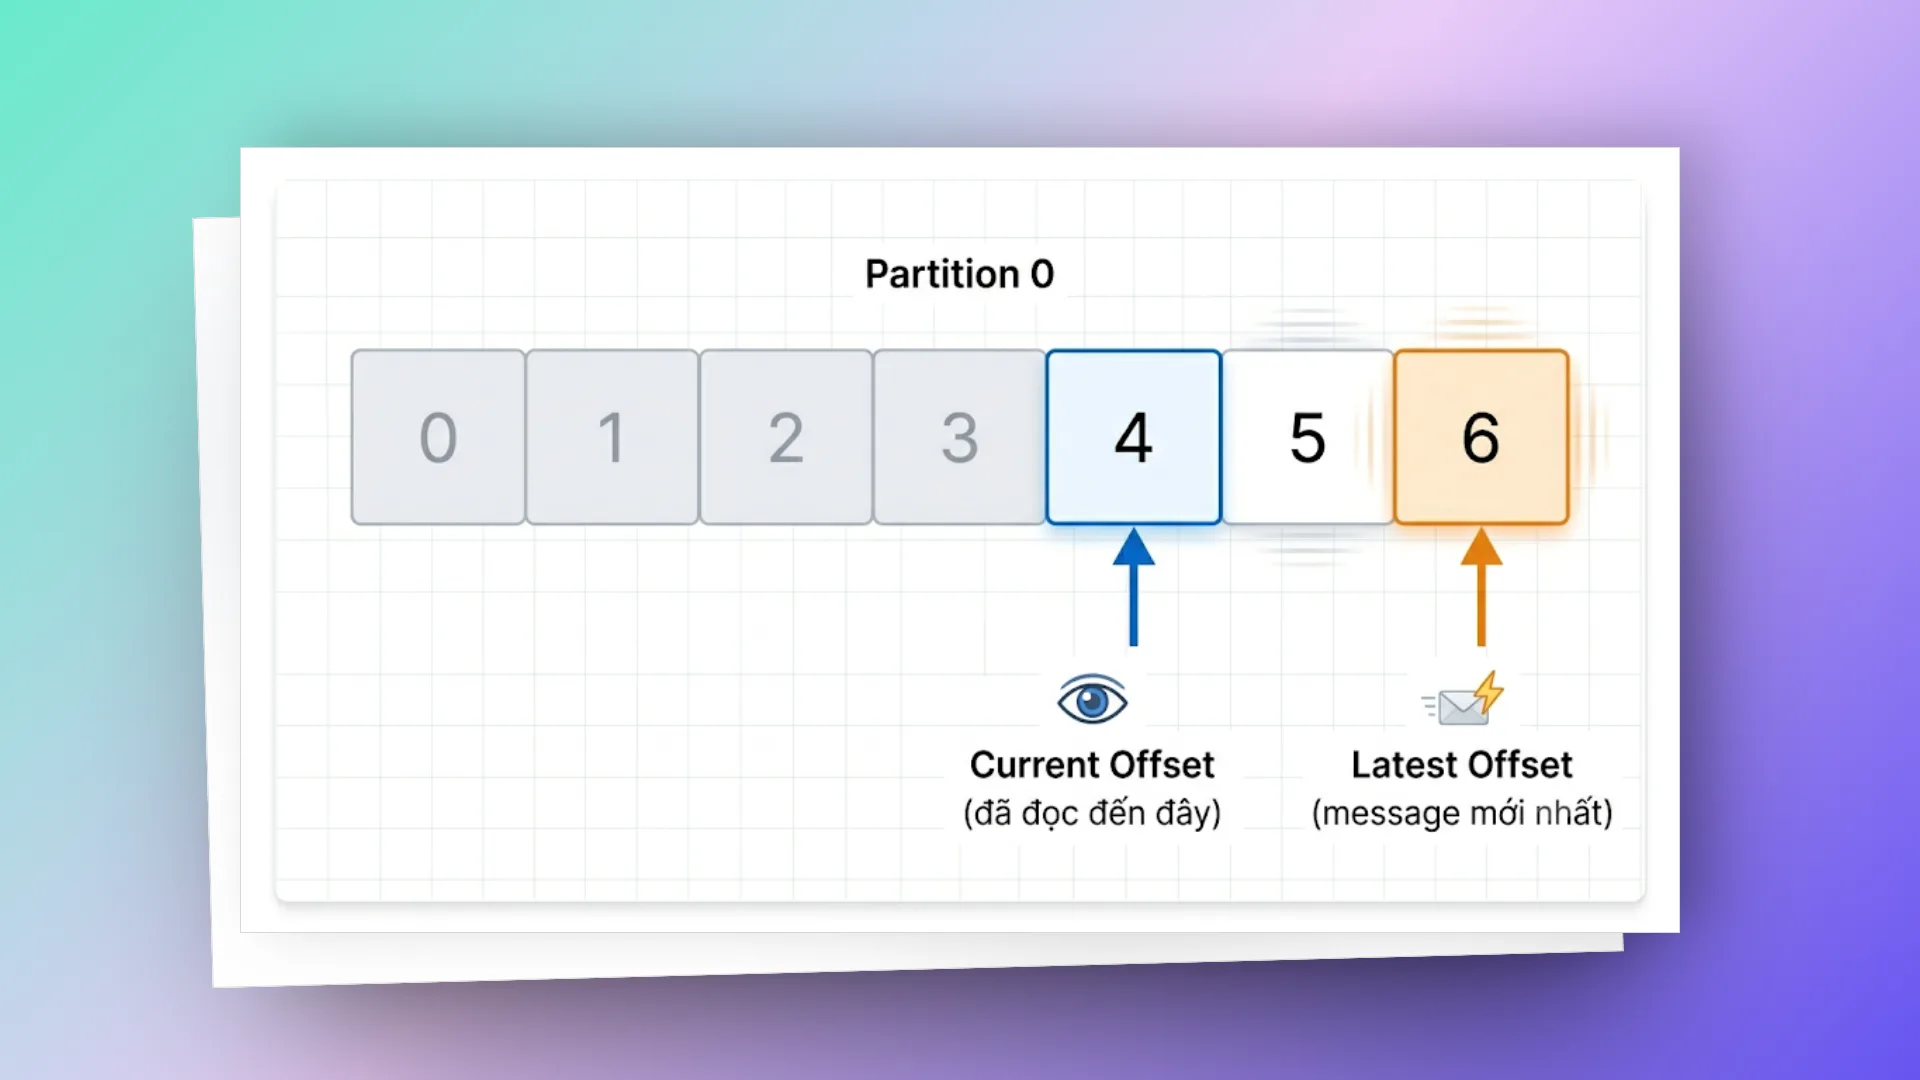
Offset đã xử lý tới đâu là do consumer quyết định và commit lên (Kafka lưu nó trong topic nội bộ __consumer_offsets), chứ broker không xoá message khi có người đọc. Nhờ vậy:
- Muốn replay messages thì reset offset về đầu (
--to-earliest) là xong. Lưu ý offset đầu chưa chắc là 0, vì message cũ hơn retention đã bị xoá - Nhiều consumer group đọc cùng một topic, mỗi group đứng ở một vị trí khác nhau, không ai ảnh hưởng ai
- Consumer có crash thì lúc chạy lại nó đọc tiếp từ offset đã commit gần nhất
# consumer group: scale phía consumer
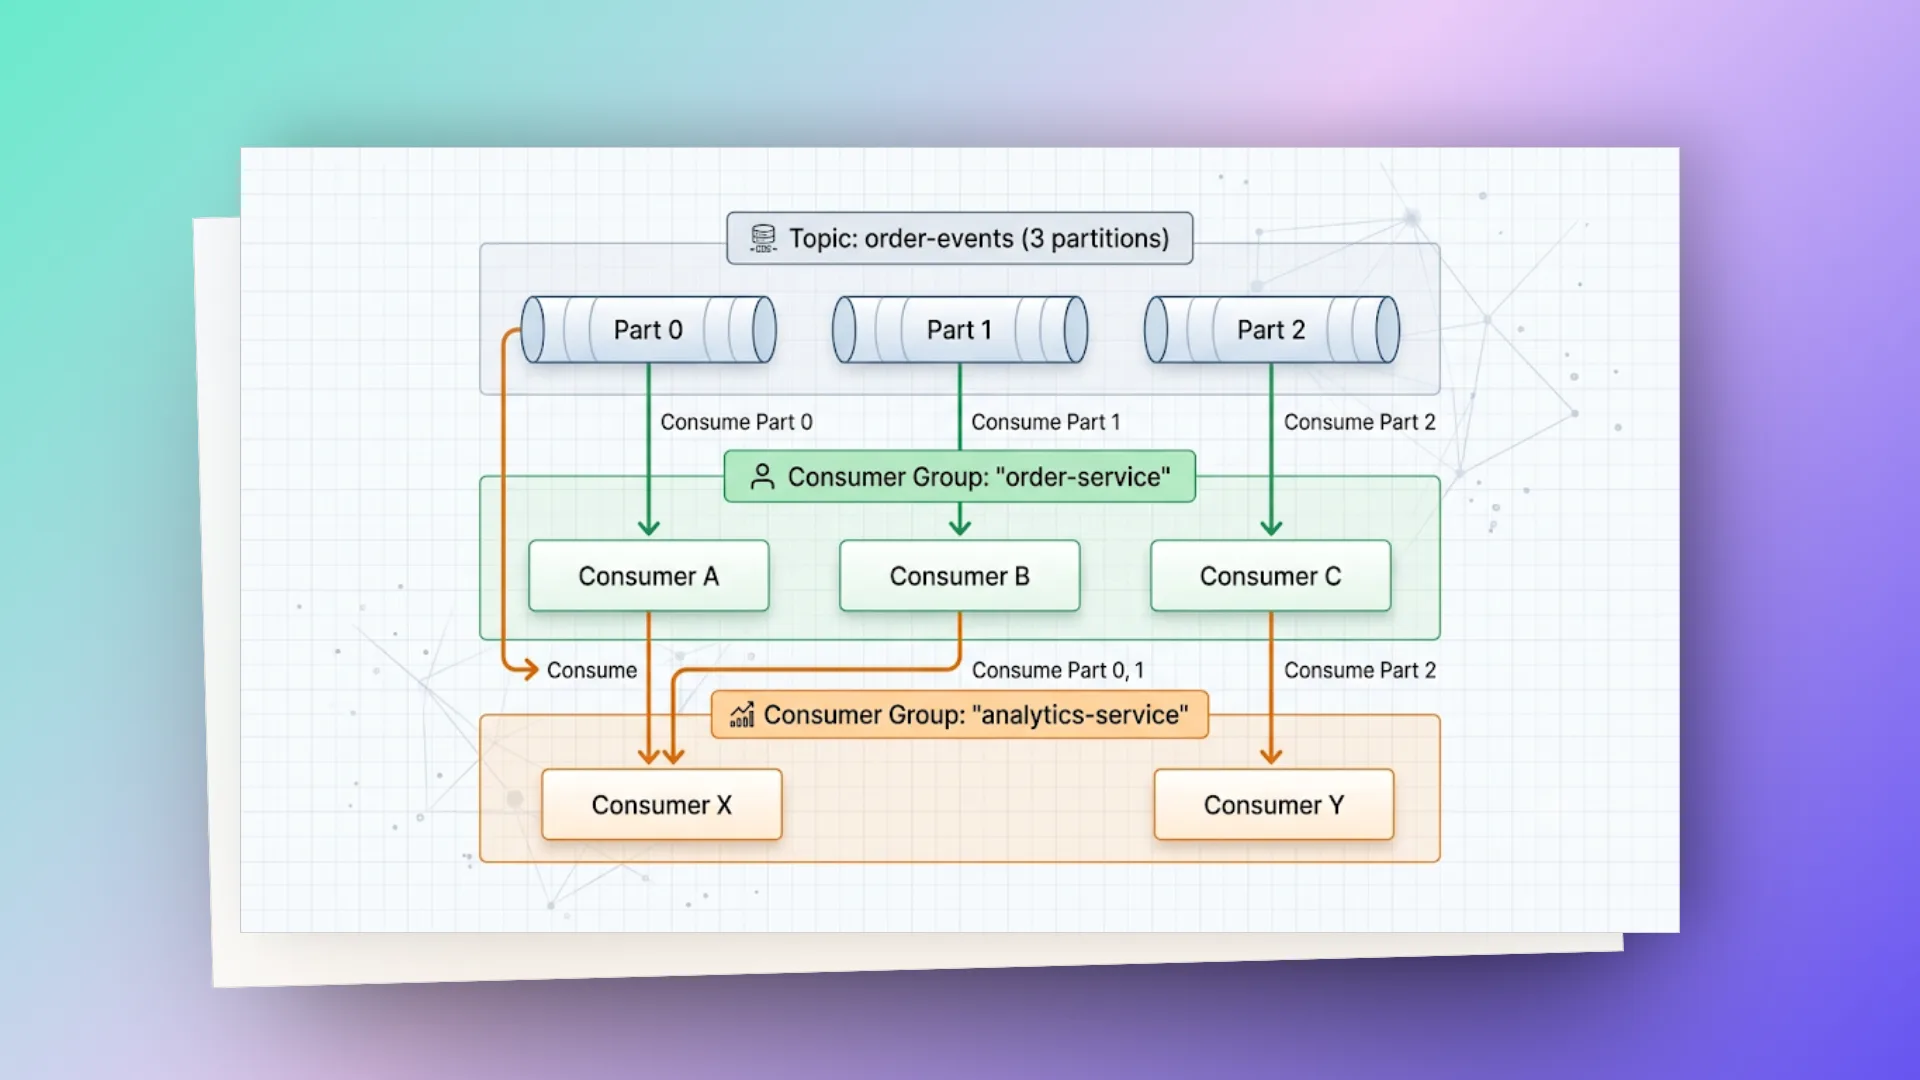
Đây là tính năng ăn tiền của Kafka. Consumer group là một nhóm consumer cùng đọc một topic, trong đó mỗi partition chỉ được giao cho đúng 1 consumer trong group.
Quy tắc:
- Số consumer trong group ≤ số partition → tối ưu
- Số consumer > số partition → mấy consumer dư ra sẽ ngồi chơi (idle)
- Thêm consumer vào group → Kafka tự rebalance
# replication: không mất dữ liệu
Mỗi partition có thể có nhiều replica nằm trên các broker khác nhau:
- Leader replica: nhận mọi writes, và mặc định cũng phục vụ reads (từ Kafka 2.4, KIP-392 cho phép consumer đọc từ follower cùng rack nếu cấu hình)
- Follower replicas: sync data từ leader, leader mà down thì có đứa lên thay
Partition 0:
  Broker 0: Leader    ← Producer writes here, Consumer reads here
  Broker 1: Follower  ← Syncs from leader
  Broker 2: Follower  ← Syncs from leader

Nếu Broker 0 chết:
  Broker 1: Leader (promoted) ← Tự động failover
  Broker 2: Follower
ISR (In-Sync Replicas): nhóm các replica đang theo kịp leader. Khi producer gửi với acks=all, leader chỉ trả lời thành công sau khi mọi replica trong ISR đã có message. min.insync.replicas=2 đặt sàn cho chuyện đó: nếu ISR co lại còn dưới 2 replica (tính cả leader) thì broker từ chối ghi với lỗi NotEnoughReplicas, thà báo lỗi còn hơn nhận message mà chỉ nằm trên một máy. Cấu hình này chỉ có tác dụng với acks=all.
# kafka message anatomy
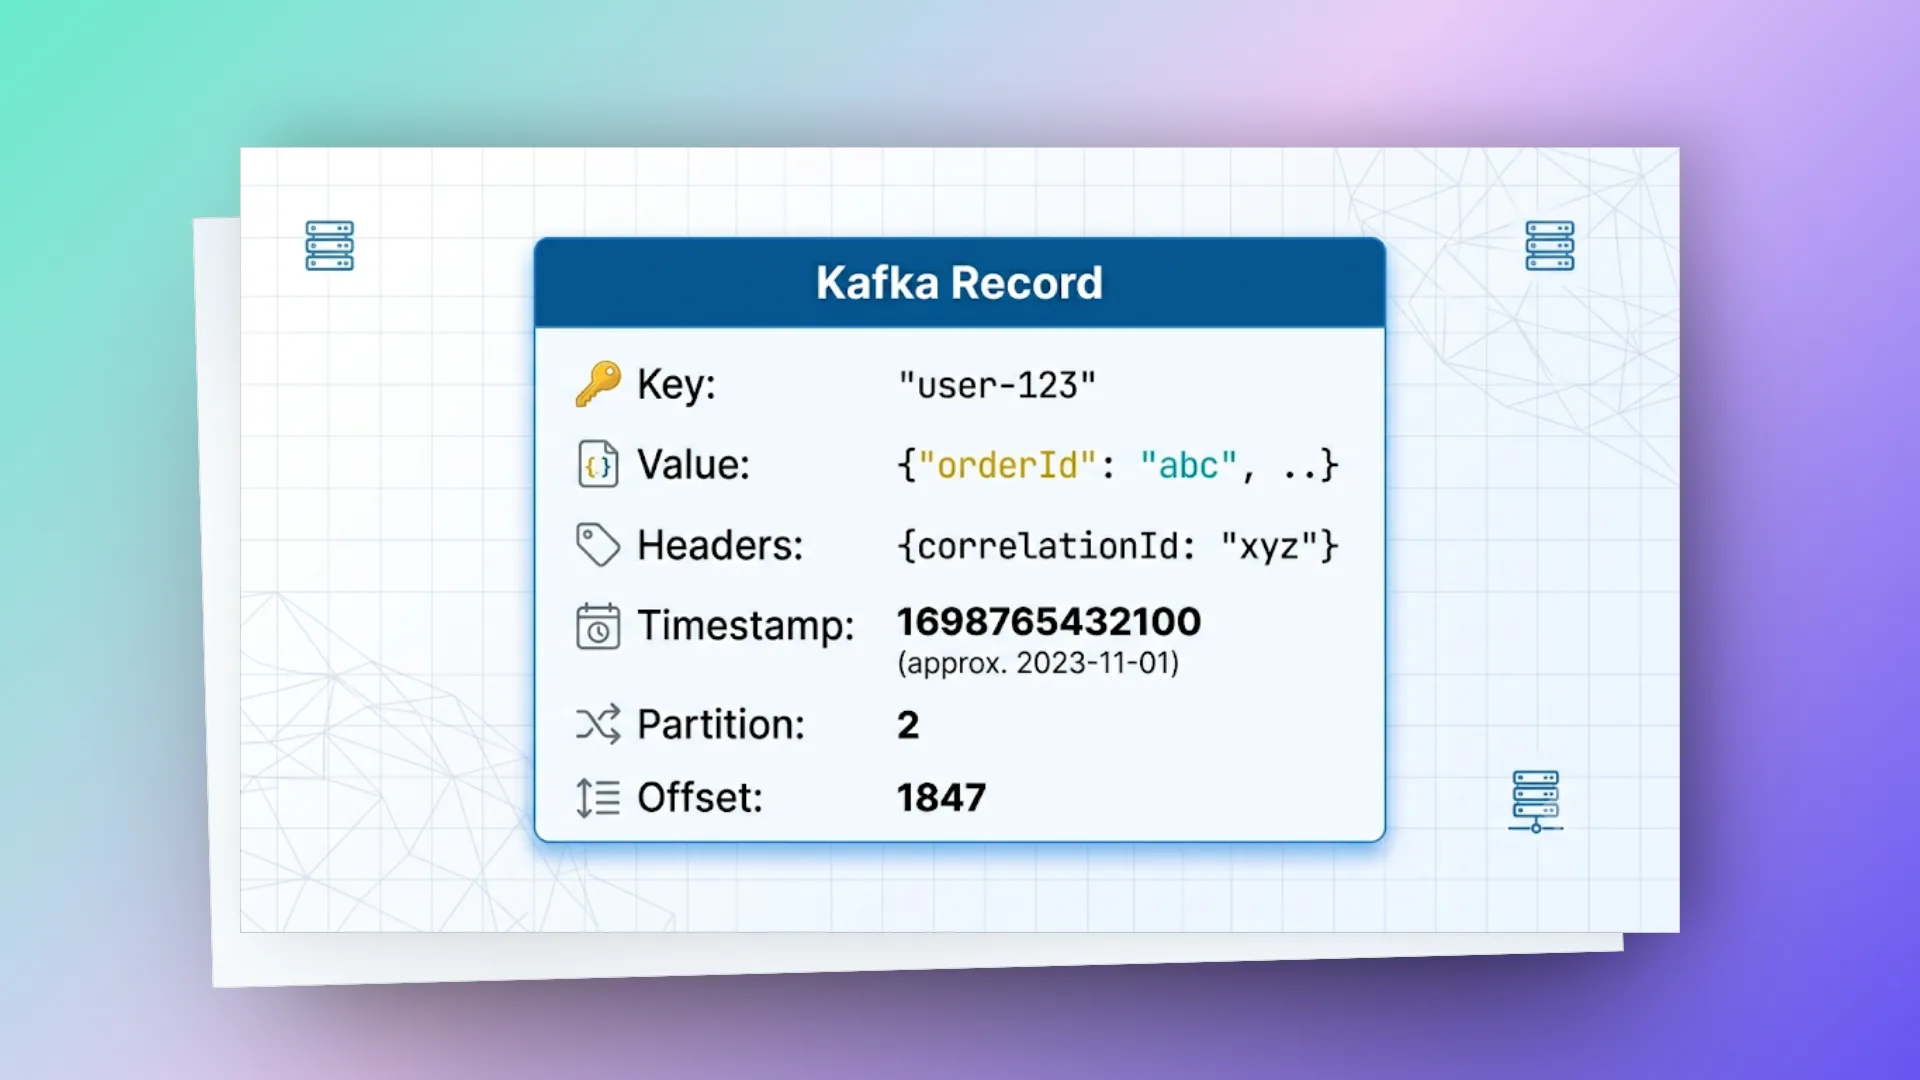
- Key: quyết định message vào partition nào. Cùng key = cùng partition = giữ được thứ tự
- Value: payload chính (thường là JSON hoặc Avro)
- Headers: metadata thêm (correlation ID, trace ID, ...)
- Timestamp: lúc message được tạo hoặc được append
# hands-on: kafka với spring boot
Lý thuyết vậy đủ rồi, code thôi.
# project setup
<!-- pom.xml -->
<dependencies>
    <dependency>
        <groupId>org.springframework.boot</groupId>
        <artifactId>spring-boot-starter-web</artifactId>
    </dependency>
    <dependency>
        <groupId>org.springframework.kafka</groupId>
        <artifactId>spring-kafka</artifactId>
    </dependency>
    <dependency>
        <groupId>com.fasterxml.jackson.core</groupId>
        <artifactId>jackson-databind</artifactId>
    </dependency>

    <!-- Test -->
    <dependency>
        <groupId>org.springframework.kafka</groupId>
        <artifactId>spring-kafka-test</artifactId>
        <scope>test</scope>
    </dependency>
</dependencies>
# configuration: application.yml
spring:
  kafka:
    bootstrap-servers: localhost:9092

    producer:
      key-serializer: org.apache.kafka.common.serialization.StringSerializer
      value-serializer: org.springframework.kafka.support.serializer.JsonSerializer
      acks: all # Đợi tất cả ISR confirm → không mất data
      retries: 3 # Retry khi gặp transient errors
      properties:
        enable.idempotence: true # Tránh duplicate messages khi retry
        max.in.flight.requests.per.connection: 5

    consumer:
      group-id: order-service
      key-deserializer: org.apache.kafka.common.serialization.StringDeserializer
      value-deserializer: org.springframework.kafka.support.serializer.JsonDeserializer
      auto-offset-reset: earliest # Đọc từ đầu nếu chưa có committed offset
      properties:
        spring.json.trusted.packages: '*'

    # KafkaAdmin: tạo các topic khai báo bằng bean NewTopic (xem phần topic configuration)
    admin:
      properties:
        bootstrap.servers: localhost:9092
⚠️ Production tip: đừng bao giờ bật
auto.create.topics.enable=truetrên production. Topic nào cũng nên tạo tay, ghi rõ số partition và replication factor.
Vài điểm trong config trên nên biết thêm. Từ Kafka 3.0, producer mặc định đã là acks=all và enable.idempotence=true, ghi rõ ra chỉ để người đọc config hiểu ý đồ. retries: 3 thực ra hạ thấp mặc định (mặc định là gần như vô hạn, giới hạn bằng delivery.timeout.ms 2 phút), nên nhiều team bỏ dòng này. spring.json.trusted.packages: '*' cho phép deserialize ra bất kỳ class nào theo type header của message, tiện cho demo nhưng lên production nên ghi đúng package của mình.
Nếu bạn dùng Spring Boot 4 / Spring for Apache Kafka 4.x thì JsonSerializer/JsonDeserializer đã bị deprecate, thay bằng JacksonJsonSerializer/JacksonJsonDeserializer chạy trên Jackson 3 (what's new). Code trong bài viết theo Spring Kafka 3.x, đổi tên class là chạy.
# domain model: order event
// OrderEvent.java
public class OrderEvent {

    private String orderId;
    private String userId;
    private String product;
    private BigDecimal amount;
    private OrderStatus status;
    private LocalDateTime timestamp;

    public enum OrderStatus {
        CREATED, CONFIRMED, SHIPPED, DELIVERED, CANCELLED
    }

    // Constructor mặc định cần cho deserialization
    public OrderEvent() {}

    public OrderEvent(String orderId, String userId, String product,
                      BigDecimal amount, OrderStatus status) {
        this.orderId = orderId;
        this.userId = userId;
        this.product = product;
        this.amount = amount;
        this.status = status;
        this.timestamp = LocalDateTime.now();
    }

    // Getters & Setters (hoặc dùng Lombok @Data)
    public String getOrderId() { return orderId; }
    public void setOrderId(String orderId) { this.orderId = orderId; }
    public String getUserId() { return userId; }
    public void setUserId(String userId) { this.userId = userId; }
    public String getProduct() { return product; }
    public void setProduct(String product) { this.product = product; }
    public BigDecimal getAmount() { return amount; }
    public void setAmount(BigDecimal amount) { this.amount = amount; }
    public OrderStatus getStatus() { return status; }
    public void setStatus(OrderStatus status) { this.status = status; }
    public LocalDateTime getTimestamp() { return timestamp; }
    public void setTimestamp(LocalDateTime timestamp) { this.timestamp = timestamp; }

    @Override
    public String toString() {
        return "OrderEvent{orderId='%s', userId='%s', status=%s, amount=%s}"
                .formatted(orderId, userId, status, amount);
    }
}
# topic configuration
// KafkaTopicConfig.java
@Configuration
public class KafkaTopicConfig {

    @Bean
    public NewTopic orderEventsTopic() {
        return TopicBuilder.name("order-events")
                .partitions(6)           // 6 partitions cho parallel processing
                .replicas(3)             // 3 replicas cho fault tolerance
                .config(TopicConfig.RETENTION_MS_CONFIG, "604800000") // 7 ngày
                .config(TopicConfig.MIN_IN_SYNC_REPLICAS_CONFIG, "2")
                .build();
    }

    @Bean
    public NewTopic orderEventsDLT() {
        // Dead Letter Topic — nơi chứa messages xử lý thất bại
        // Số partition phải >= topic gốc: DeadLetterPublishingRecoverer
        // mặc định gửi vào cùng số partition với record gốc
        return TopicBuilder.name("order-events.DLT")
                .partitions(6)
                .replicas(3)
                .build();
    }
}
# producer: gửi events
// OrderEventProducer.java
@Service
@Slf4j
public class OrderEventProducer {

    private final KafkaTemplate<String, OrderEvent> kafkaTemplate;

    // Constructor injection — best practice
    public OrderEventProducer(KafkaTemplate<String, OrderEvent> kafkaTemplate) {
        this.kafkaTemplate = kafkaTemplate;
    }

    /**
     * Gửi order event lên Kafka.
     * Key = userId → tất cả events của cùng user vào cùng partition
     * → đảm bảo ordering per user.
     */
    public CompletableFuture<SendResult<String, OrderEvent>> publishOrderEvent(
            OrderEvent event) {

        log.info("Publishing event: {}", event);

        return kafkaTemplate
                .send("order-events", event.getUserId(), event)
                .whenComplete((result, ex) -> {
                    if (ex == null) {
                        log.info("Event sent successfully: topic={}, partition={}, offset={}",
                                result.getRecordMetadata().topic(),
                                result.getRecordMetadata().partition(),
                                result.getRecordMetadata().offset());
                    } else {
                        log.error("Failed to send event: {}", event, ex);
                        // Ở đây bạn có thể: retry, gửi vào DLQ, alert, ...
                    }
                });
    }

    /**
     * Gửi event với custom headers — hữu ích cho tracing.
     */
    public void publishWithHeaders(OrderEvent event, String correlationId) {
        ProducerRecord<String, OrderEvent> record =
                new ProducerRecord<>("order-events", event.getUserId(), event);

        record.headers()
                .add("correlationId", correlationId.getBytes(StandardCharsets.UTF_8))
                .add("source", "order-service".getBytes(StandardCharsets.UTF_8));

        kafkaTemplate.send(record);
    }
}
# consumer: nhận và xử lý events
// OrderEventConsumer.java
@Service
@Slf4j
public class OrderEventConsumer {

    private final OrderService orderService;

    public OrderEventConsumer(OrderService orderService) {
        this.orderService = orderService;
    }

    /**
     * Consumer cơ bản — đủ cho hầu hết use cases.
     *
     * concurrency = 3 → Spring tạo 3 consumer threads,
     * mỗi thread xử lý 1 hoặc nhiều partitions.
     */
    @KafkaListener(
            topics = "order-events",
            groupId = "order-service",
            concurrency = "3"
    )
    public void handleOrderEvent(
            @Payload OrderEvent event,
            @Header(KafkaHeaders.RECEIVED_PARTITION) int partition,
            @Header(KafkaHeaders.OFFSET) long offset,
            @Header(KafkaHeaders.RECEIVED_TIMESTAMP) long timestamp) {

        log.info("Received event: {} [partition={}, offset={}]",
                event, partition, offset);

        try {
            orderService.processOrder(event);
        } catch (Exception e) {
            log.error("Error processing event at offset {}: {}",
                    offset, e.getMessage());
            // Throw lại để Kafka retry hoặc gửi vào DLT
            throw e;
        }
    }

    /**
     * Consumer với manual acknowledgment — khi bạn cần kiểm soát
     * chính xác lúc nào offset được commit.
     */
    @KafkaListener(
            topics = "order-events",
            groupId = "order-service-manual-ack",
            containerFactory = "manualAckListenerFactory"
    )
    public void handleWithManualAck(
            OrderEvent event,
            Acknowledgment acknowledgment) {

        try {
            orderService.processOrder(event);
            // Chỉ commit offset khi xử lý thành công
            acknowledgment.acknowledge();
        } catch (Exception e) {
            // Chỉ "không acknowledge" thì KHÔNG đủ: consumer vẫn poll tiếp,
            // lần ack sau commit offset lớn hơn và message này bị bỏ qua.
            // nack() seek lại về message này, đợi 1s rồi giao lại.
            log.error("Processing failed, will retry: {}", e.getMessage());
            acknowledgment.nack(Duration.ofSeconds(1));
        }
    }

    /**
     * Batch consumer — xử lý nhiều messages cùng lúc.
     * Hiệu quả hơn khi cần bulk insert vào DB.
     */
    @KafkaListener(
            topics = "order-events",
            groupId = "order-service-batch",
            containerFactory = "batchListenerFactory"
    )
    public void handleBatch(List<OrderEvent> events) {
        log.info("Received batch of {} events", events.size());
        orderService.processBatch(events);
    }
}
# consumer factory configuration
// KafkaConsumerConfig.java
@Configuration
@EnableKafka
public class KafkaConsumerConfig {

    @Value("${spring.kafka.bootstrap-servers}")
    private String bootstrapServers;

    @Bean
    public ConsumerFactory<String, OrderEvent> consumerFactory() {
        Map<String, Object> props = new HashMap<>();
        props.put(ConsumerConfig.BOOTSTRAP_SERVERS_CONFIG, bootstrapServers);
        props.put(ConsumerConfig.KEY_DESERIALIZER_CLASS_CONFIG,
                StringDeserializer.class);
        props.put(ConsumerConfig.VALUE_DESERIALIZER_CLASS_CONFIG,
                JsonDeserializer.class);
        props.put(JsonDeserializer.TRUSTED_PACKAGES, "*");
        props.put(ConsumerConfig.AUTO_OFFSET_RESET_CONFIG, "earliest");
        return new DefaultKafkaConsumerFactory<>(props);
    }

    /**
     * Factory cho manual acknowledgment.
     * AckMode.MANUAL_IMMEDIATE = commit ngay khi acknowledge() được gọi.
     */
    @Bean
    public ConcurrentKafkaListenerContainerFactory<String, OrderEvent>
            manualAckListenerFactory() {

        ConcurrentKafkaListenerContainerFactory<String, OrderEvent> factory =
                new ConcurrentKafkaListenerContainerFactory<>();
        factory.setConsumerFactory(consumerFactory());
        factory.getContainerProperties()
                .setAckMode(ContainerProperties.AckMode.MANUAL_IMMEDIATE);
        return factory;
    }

    /**
     * Factory cho batch processing.
     * max.poll.records = số messages tối đa mỗi lần poll.
     */
    @Bean
    public ConcurrentKafkaListenerContainerFactory<String, OrderEvent>
            batchListenerFactory() {

        ConcurrentKafkaListenerContainerFactory<String, OrderEvent> factory =
                new ConcurrentKafkaListenerContainerFactory<>();
        factory.setConsumerFactory(consumerFactory());
        factory.setBatchListener(true);
        factory.getContainerProperties()
                .setAckMode(ContainerProperties.AckMode.BATCH);
        return factory;
    }
}
# error handling & dead letter topic
Phần này hay bị bỏ qua, mà lên production thì lại cực kỳ quan trọng.
// KafkaErrorHandlingConfig.java
@Configuration
public class KafkaErrorHandlingConfig {

    /**
     * Retry 3 lần với backoff tăng dần, sau đó gửi vào Dead Letter Topic.
     *
     * Flow: message → retry 1 (1s) → retry 2 (2s) → retry 3 (4s) → DLT
     */
    @Bean
    public DefaultErrorHandler errorHandler(
            KafkaOperations<String, OrderEvent> kafkaOperations) {

        // Gửi message thất bại vào DLT
        DeadLetterPublishingRecoverer recoverer =
                new DeadLetterPublishingRecoverer(kafkaOperations,
                        (record, ex) -> new TopicPartition(
                                record.topic() + ".DLT",
                                record.partition()));

        // Retry đúng 3 lần với exponential backoff 1s, 2s, 4s
        ExponentialBackOffWithMaxRetries backOff = new ExponentialBackOffWithMaxRetries(3);
        backOff.setInitialInterval(1000L);
        backOff.setMultiplier(2.0);

        DefaultErrorHandler errorHandler =
                new DefaultErrorHandler(recoverer, backOff);

        // Không retry cho các lỗi không thể recover
        errorHandler.addNotRetryableExceptions(
                DeserializationException.class,
                ClassCastException.class,
                NullPointerException.class
        );

        return errorHandler;
    }
}
Mấy chỗ dễ vấp ở đoạn này. Một là lớp ExponentialBackOff của Spring dừng theo tổng thời gian chờ: với maxElapsedTime = 15s nó sẽ retry 4 lần (1 + 2 + 4 + 8 = 15s) chứ không phải 3, nên muốn đúng số lần thì dùng ExponentialBackOffWithMaxRetries như trên. Hai là DeadLetterPublishingRecoverer mặc định gửi record hỏng vào cùng số partition ở topic .DLT, nên DLT phải có ít nhất bằng số partition của topic gốc, không thì gửi DLT cũng lỗi. Ba là Spring Boot chỉ tự gắn bean DefaultErrorHandler vào container factory mặc định do Boot tạo. Mấy factory tự khai báo như manualAckListenerFactory, batchListenerFactory ở trên thì phải gọi factory.setCommonErrorHandler(errorHandler) bằng tay.
DeserializationException và ClassCastException thật ra đã nằm sẵn trong danh sách không retry mặc định của DefaultErrorHandler, ghi thêm cho rõ ý cũng không sao.
# rest controller: trigger events
// OrderController.java
@RestController
@RequestMapping("/api/orders")
public class OrderController {

    private final OrderEventProducer producer;

    public OrderController(OrderEventProducer producer) {
        this.producer = producer;
    }

    @PostMapping
    public ResponseEntity<Map<String, String>> createOrder(
            @RequestBody CreateOrderRequest request) {

        OrderEvent event = new OrderEvent(
                UUID.randomUUID().toString(),
                request.getUserId(),
                request.getProduct(),
                request.getAmount(),
                OrderEvent.OrderStatus.CREATED
        );

        producer.publishOrderEvent(event);

        return ResponseEntity.accepted()
                .body(Map.of(
                        "orderId", event.getOrderId(),
                        "status", "ACCEPTED",
                        "message", "Order event published to Kafka"
                ));
    }
}
# mấy pattern team tôi dùng hằng ngày
# pattern 1: transactional outbox
Bài toán kinh điển: bạn cần vừa save vào DB, vừa publish event lên Kafka. Một trong hai mà fail là data lệch nhau ngay.
❌ Cách sai:
1. Save to DB     ← Thành công
2. Publish Kafka  ← Fail → DB có data nhưng Kafka không có event

❌ Cách sai ngược:
1. Publish Kafka  ← Thành công
2. Save to DB     ← Fail → Kafka có event nhưng DB không có data
Cách xử lý: Transactional Outbox Pattern
// OutboxEvent entity — lưu event vào cùng DB transaction với business data
@Entity
@Table(name = "outbox_events")
public class OutboxEvent {

    @Id
    private String id;
    private String aggregateType;  // "Order"
    private String aggregateId;    // orderId
    private String eventType;      // "OrderCreated"

    @Column(columnDefinition = "TEXT")
    private String payload;        // JSON serialized event

    private LocalDateTime createdAt;
    private boolean published;

    // constructors, getters, setters...
}

// Service — save business data + outbox event trong cùng 1 transaction
@Service
@Transactional
@RequiredArgsConstructor
public class OrderService {

    private final OrderRepository orderRepository;
    private final OutboxRepository outboxRepository;
    private final ObjectMapper objectMapper;

    public Order createOrder(CreateOrderRequest request) {
        // 1. Save business data
        Order order = new Order(request);
        orderRepository.save(order);

        // 2. Save outbox event (cùng transaction)
        OutboxEvent outboxEvent = new OutboxEvent();
        outboxEvent.setId(UUID.randomUUID().toString());
        outboxEvent.setAggregateType("Order");
        outboxEvent.setAggregateId(order.getId());
        outboxEvent.setEventType("OrderCreated");
        try {
            outboxEvent.setPayload(objectMapper.writeValueAsString(order));
        } catch (JsonProcessingException e) {
            // Checked exception: @Transactional mặc định KHÔNG rollback
            // với checked exception, nên bọc lại thành unchecked
            throw new IllegalStateException("Cannot serialize order", e);
        }
        outboxEvent.setCreatedAt(LocalDateTime.now());
        outboxEvent.setPublished(false);
        outboxRepository.save(outboxEvent);

        return order;
        // Cả hai save cùng commit hoặc cùng rollback
    }
}

// Scheduler — poll outbox table và publish lên Kafka
@Component
@Slf4j
@RequiredArgsConstructor
public class OutboxPublisher {

    private final OutboxRepository outboxRepository;
    // KafkaTemplate riêng dùng StringSerializer: payload đã là JSON sẵn,
    // đi qua JsonSerializer nữa sẽ thành chuỗi JSON bị bọc trong dấu nháy
    private final KafkaTemplate<String, String> kafkaTemplate;

    @Scheduled(fixedDelay = 1000) // Poll mỗi giây
    @Transactional
    public void publishPendingEvents() {
        List<OutboxEvent> events =
                outboxRepository.findByPublishedFalseOrderByCreatedAtAsc();

        for (OutboxEvent event : events) {
            try {
                kafkaTemplate.send(
                        event.getAggregateType().toLowerCase() + "-events",
                        event.getAggregateId(),
                        event.getPayload()
                ).get(); // Blocking wait để đảm bảo gửi thành công

                event.setPublished(true);
                outboxRepository.save(event);
            } catch (Exception e) {
                log.error("Failed to publish outbox event: {}", event.getId(), e);
                break; // Dừng lại, retry ở lần poll tiếp theo
            }
        }
    }
}
Outbox cho bạn at-least-once chứ không phải exactly-once: nếu gửi Kafka xong mà commit DB lỗi (hoặc app chết giữa chừng), lần poll sau event được gửi lại. Nên consumer phía sau vẫn phải idempotent (xem phần idempotent consumer bên dưới). Chạy nhiều instance thì các scheduler sẽ giành nhau cùng một dòng, cần khoá kiểu SELECT ... FOR UPDATE SKIP LOCKED hoặc chỉ cho một instance chạy (ShedLock chẳng hạn). Muốn bỏ hẳn polling thì dùng CDC: Debezium đọc thẳng transaction log của DB và đẩy bảng outbox lên Kafka.
# pattern 2: event sourcing với Kafka
Thay vì lưu state hiện tại, bạn lưu lại mọi event đã xảy ra. Cần state thì replay events để dựng lại.
// Các events cho Order aggregate
public sealed interface OrderDomainEvent {
    String orderId();

    record OrderCreated(String orderId, String userId,
                        String product, BigDecimal amount) implements OrderDomainEvent {}

    record OrderConfirmed(String orderId, LocalDateTime confirmedAt)
            implements OrderDomainEvent {}

    record OrderShipped(String orderId, String trackingNumber)
            implements OrderDomainEvent {}

    record OrderCancelled(String orderId, String reason)
            implements OrderDomainEvent {}
}

// Rebuild state từ events
public class OrderAggregate {

    private String orderId;
    private String userId;
    private OrderStatus status;
    private BigDecimal amount;
    private String trackingNumber;

    public static OrderAggregate replayEvents(List<OrderDomainEvent> events) {
        OrderAggregate aggregate = new OrderAggregate();
        events.forEach(aggregate::apply);
        return aggregate;
    }

    private void apply(OrderDomainEvent event) {
        switch (event) {
            case OrderDomainEvent.OrderCreated e -> {
                this.orderId = e.orderId();
                this.userId = e.userId();
                this.amount = e.amount();
                this.status = OrderStatus.CREATED;
            }
            case OrderDomainEvent.OrderConfirmed e -> {
                this.status = OrderStatus.CONFIRMED;
            }
            case OrderDomainEvent.OrderShipped e -> {
                this.status = OrderStatus.SHIPPED;
                this.trackingNumber = e.trackingNumber();
            }
            case OrderDomainEvent.OrderCancelled e -> {
                this.status = OrderStatus.CANCELLED;
            }
        }
    }
}
Dùng Kafka làm event store có một cái vướng: Kafka không truy vấn được "mọi event của order X" một cách hiệu quả, và không có optimistic concurrency kiểu "chỉ ghi nếu version hiện tại là 5". Vì vậy nhiều hệ thống lưu event vào một event store riêng (bảng append-only trong DB, EventStoreDB...) rồi mới publish lên Kafka cho các service khác, còn Kafka đóng vai kênh phân phối event.
# pattern 3: saga pattern cho distributed transactions
Khi một nghiệp vụ phải chạy qua nhiều service, bạn sẽ cần tới Saga pattern.
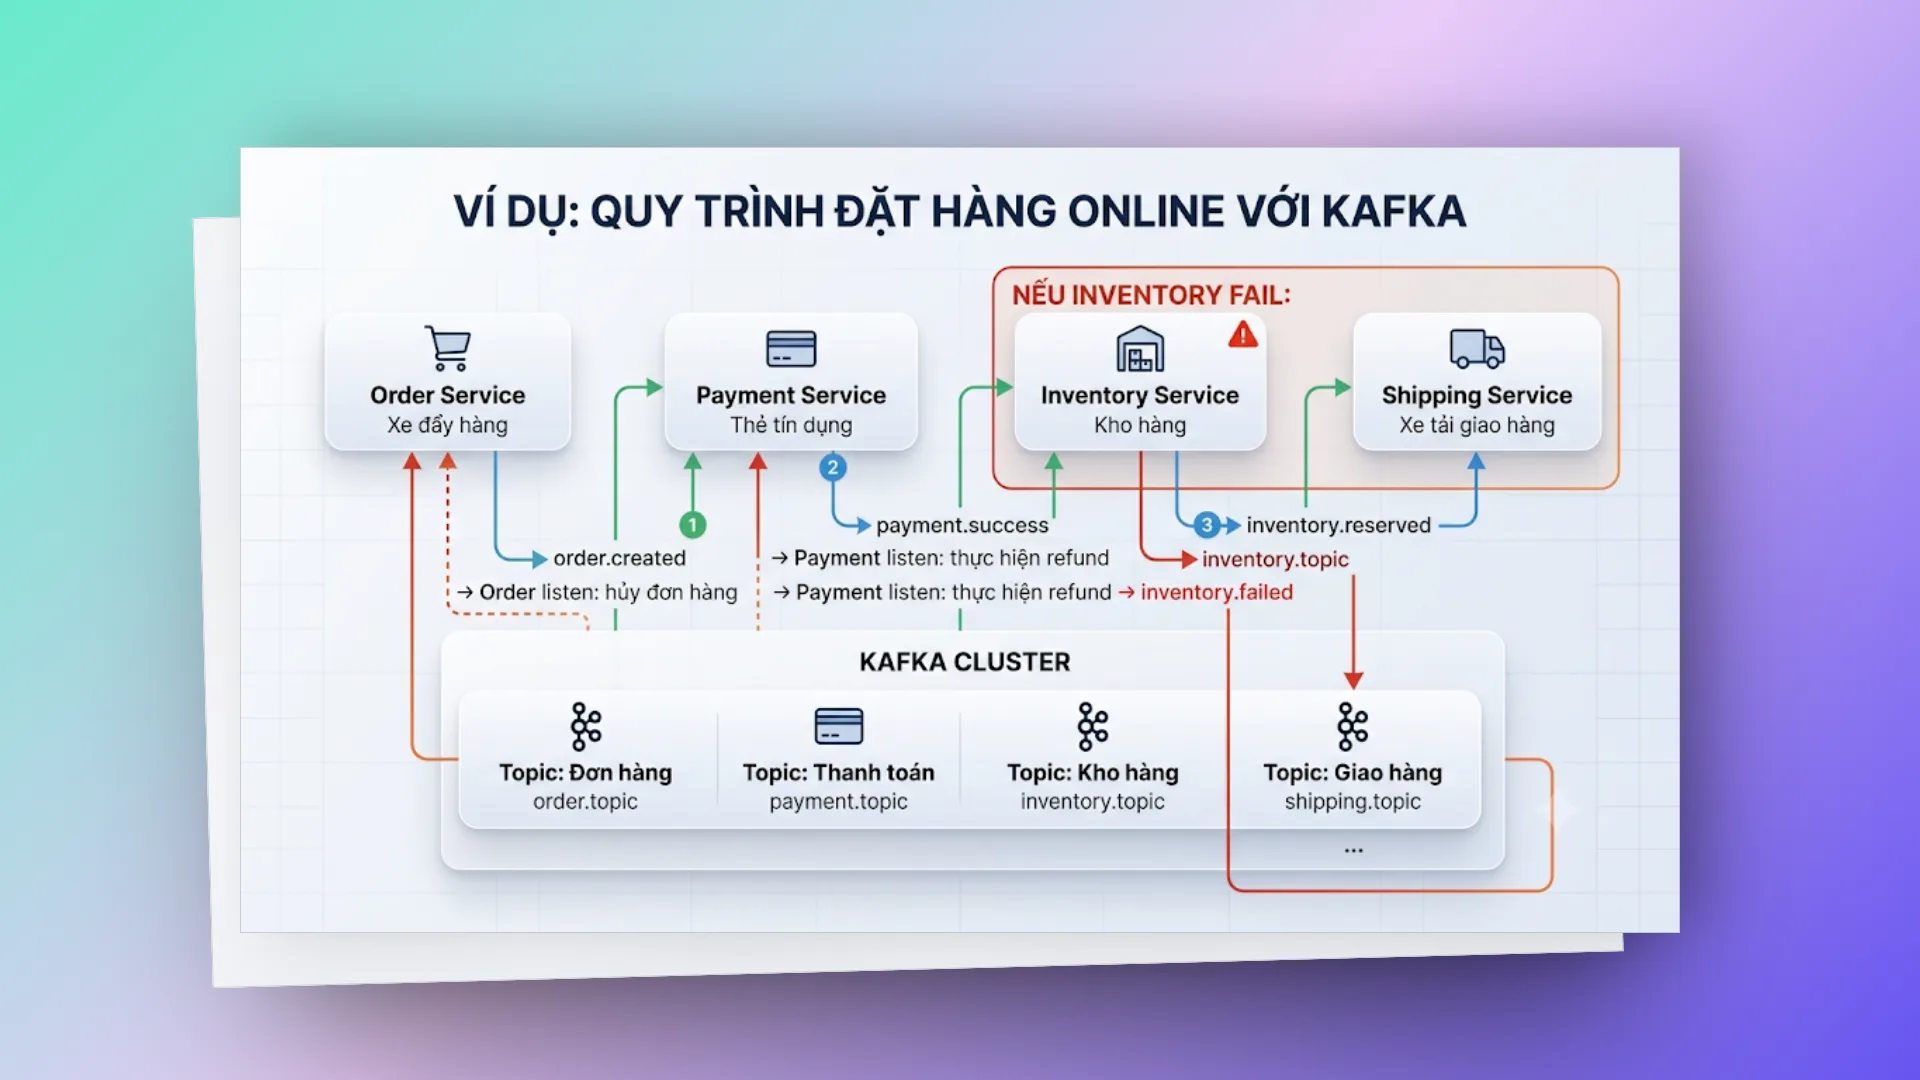
Code Java thì trông thế này:
// Orchestrator-based Saga
@Service
@Slf4j
@RequiredArgsConstructor
public class OrderSagaOrchestrator {

    private final KafkaTemplate<String, SagaEvent> kafkaTemplate;

    @KafkaListener(topics = "saga-order-reply", groupId = "saga-orchestrator")
    public void handleSagaReply(SagaEvent event) {
        switch (event.getStep()) {
            case "PAYMENT_SUCCESS" -> {
                log.info("Payment successful, reserving inventory...");
                kafkaTemplate.send("saga-inventory-request",
                        event.getOrderId(),
                        SagaEvent.of(event.getOrderId(), "RESERVE_INVENTORY"));
            }
            case "INVENTORY_RESERVED" -> {
                log.info("Inventory reserved, initiating shipping...");
                kafkaTemplate.send("saga-shipping-request",
                        event.getOrderId(),
                        SagaEvent.of(event.getOrderId(), "CREATE_SHIPMENT"));
            }
            case "PAYMENT_FAILED" -> {
                log.warn("Payment failed, cancelling order...");
                kafkaTemplate.send("saga-order-request",
                        event.getOrderId(),
                        SagaEvent.of(event.getOrderId(), "CANCEL_ORDER"));
            }
            case "INVENTORY_FAILED" -> {
                log.warn("Inventory failed, refunding payment...");
                kafkaTemplate.send("saga-payment-request",
                        event.getOrderId(),
                        SagaEvent.of(event.getOrderId(), "REFUND_PAYMENT"));
            }
        }
    }
}
# kafka streams: xử lý ngay trong kafka
Kafka Streams là một thư viện Java chạy ngay trong app của bạn: đọc từ topic, xử lý (filter, join, aggregate theo window), rồi ghi kết quả ra topic khác. Nó không chạy bên trong broker, nhưng cũng không cần dựng cluster xử lý riêng như Flink hay Spark. State (ví dụ tổng doanh thu theo user) nằm ở RocksDB local và được backup vào changelog topic trên Kafka, app chết thì instance khác dựng lại từ đó.
// Real-time order analytics với Kafka Streams
@Configuration
@EnableKafkaStreams
public class OrderAnalyticsStream {

    @Bean
    public KStream<String, OrderEvent> orderAnalytics(
            StreamsBuilder streamsBuilder) {

        // Đọc từ topic
        KStream<String, OrderEvent> orderStream = streamsBuilder
                .stream("order-events",
                        Consumed.with(Serdes.String(), orderEventSerde()));

        // 1. Filter: chỉ lấy orders đã confirmed
        KStream<String, OrderEvent> confirmedOrders = orderStream
                .filter((key, event) ->
                        event.getStatus() == OrderEvent.OrderStatus.CONFIRMED);

        // 2. Tính tổng revenue theo user (windowed aggregation)
        KTable<Windowed<String>, BigDecimal> revenuePerUser = confirmedOrders
                .groupByKey()
                .windowedBy(TimeWindows.ofSizeWithNoGrace(Duration.ofHours(1)))
                .aggregate(
                        () -> BigDecimal.ZERO,
                        (userId, event, total) -> total.add(event.getAmount()),
                        Materialized.with(Serdes.String(), bigDecimalSerde())
                );

        // 3. Detect high-value orders → gửi alert
        orderStream
                .filter((key, event) ->
                        event.getAmount().compareTo(new BigDecimal("10000")) > 0)
                .to("high-value-order-alerts",
                        Produced.with(Serdes.String(), orderEventSerde()));

        // 4. Branch: phân loại orders theo status
        Map<String, KStream<String, OrderEvent>> branches = orderStream
                .split(Named.as("order-"))
                .branch((key, event) ->
                        event.getStatus() == OrderEvent.OrderStatus.CANCELLED,
                        Branched.as("cancelled"))
                .branch((key, event) ->
                        event.getStatus() == OrderEvent.OrderStatus.SHIPPED,
                        Branched.as("shipped"))
                .defaultBranch(Branched.as("other"));

        branches.get("order-cancelled")
                .to("cancelled-orders");

        return orderStream;
    }
}
# production checklist: mấy bài học phải trả giá mới có
# monitoring: metrics nhất định phải theo dõi
# Prometheus metrics quan trọng nhất
# (tên metric cụ thể tuỳ exporter: kafka_exporter, JMX exporter, Micrometer...)

# Consumer lag — số messages chưa được xử lý (tên theo kafka_exporter)
# Nếu lag tăng liên tục → consumer không kịp xử lý
kafka_consumergroup_lag{consumergroup="order-service", topic="order-events"}

# Producer request latency
kafka_producer_request_latency_avg

# Khoảng cách giữa 2 lần poll: nếu max tiến sát max.poll.interval.ms
# là sắp bị kick khỏi group
kafka_consumer_time_between_poll_max

# Under-replicated partitions — DẤU HIỆU NGUY HIỂM (tên theo JMX exporter)
kafka_server_replicamanager_underreplicatedpartitions
// Spring Boot Actuator + Micrometer: Boot tự gắn metrics cho producer/consumer
// factory do Boot tạo. Factory tự khai báo (như consumerFactory ở trên)
// thì phải gắn listener bằng tay, khai báo listener thành bean riêng là không đủ.
@Bean
public ConsumerFactory<String, OrderEvent> consumerFactory(MeterRegistry registry) {
DefaultKafkaConsumerFactory<String, OrderEvent> factory =
new DefaultKafkaConsumerFactory<>(consumerProps());
factory.addListener(new MicrometerConsumerListener<>(registry));
return factory;
}# idempotent consumer: xử lý message trùng
Với cách dùng thông thường (xử lý xong mới commit offset), Kafka cho bạn at-least-once delivery, tức là một message có thể tới tay consumer nhiều lần: consumer xử lý xong nhưng chết trước khi commit, rebalance giữa chừng, hay producer/outbox gửi lại. Vì vậy consumer của bạn bắt buộc phải idempotent.
@Service
@Slf4j
@RequiredArgsConstructor
public class IdempotentOrderConsumer {

    private final ProcessedEventRepository processedEventRepo;
    private final OrderService orderService;

    @KafkaListener(topics = "order-events", groupId = "order-service")
    @Transactional
    public void handle(OrderEvent event,
                       @Header(KafkaHeaders.RECEIVED_PARTITION) int partition,
                       @Header(KafkaHeaders.OFFSET) long offset) {

        // Tạo unique ID từ partition + offset (hoặc dùng event ID)
        String eventId = "order-events-%d-%d".formatted(partition, offset);

        // Check đã xử lý chưa
        if (processedEventRepo.existsById(eventId)) {
            log.warn("Duplicate event detected, skipping: {}", eventId);
            return;
        }

        // Xử lý business logic
        orderService.processOrder(event);

        // Đánh dấu đã xử lý (cùng transaction với business logic)
        processedEventRepo.save(new ProcessedEvent(eventId, LocalDateTime.now()));
    }
}
Lấy partition + offset làm khoá chỉ chặn được trường hợp cùng một record bị giao lại. Nếu producer hay outbox gửi trùng thì hai bản ghi có offset khác nhau, khoá kiểu này không bắt được. Nên trong thực tế hãy để producer gắn một event ID duy nhất (UUID trong payload hoặc header) và dedupe theo nó, bảng processed_events đặt khoá chính trên cột đó để DB chặn luôn cả trường hợp hai luồng chạy đua.
# performance tuning
# Producer tuning
spring:
  kafka:
    producer:
      # Batch messages trước khi gửi → tăng throughput
      batch-size: 32768 # 32KB
      # Đợi tối đa 5ms để gom batch
      properties:
        linger.ms: 5 # Kafka 4.0 trở đi mặc định đã là 5ms (trước đó là 0)
        # Compression — giảm network bandwidth
        compression.type: lz4 # lz4 = fast, snappy = balanced, zstd = best ratio
        # Buffer memory cho producer
        buffer.memory: 67108864 # 64MB

    consumer:
      # Số messages tối đa mỗi lần poll
      properties:
        max.poll.records: 500
        # Thời gian tối đa giữa 2 lần poll
        # Nếu vượt quá → consumer bị coi là dead → rebalance
        max.poll.interval.ms: 300000 # 5 phút
        # Fetch size
        fetch.min.bytes: 1024
        fetch.max.wait.ms: 500
Docker Compose cho Local Development
# docker-compose.yml
services:
  zookeeper:
    image: confluentinc/cp-zookeeper:7.5.0
    environment:
      ZOOKEEPER_CLIENT_PORT: 2181
      ZOOKEEPER_TICK_TIME: 2000

  kafka:
    image: confluentinc/cp-kafka:7.5.0
    depends_on:
      - zookeeper
    ports:
      - '9092:9092'
    environment:
      KAFKA_BROKER_ID: 1
      KAFKA_ZOOKEEPER_CONNECT: zookeeper:2181
      # 2 listener: app trên máy host gọi localhost:9092,
      # container khác (kafka-ui) gọi kafka:29092
      KAFKA_LISTENERS: INTERNAL://0.0.0.0:29092,EXTERNAL://0.0.0.0:9092
      KAFKA_ADVERTISED_LISTENERS: INTERNAL://kafka:29092,EXTERNAL://localhost:9092
      KAFKA_LISTENER_SECURITY_PROTOCOL_MAP: INTERNAL:PLAINTEXT,EXTERNAL:PLAINTEXT
      KAFKA_INTER_BROKER_LISTENER_NAME: INTERNAL
      KAFKA_OFFSETS_TOPIC_REPLICATION_FACTOR: 1
      KAFKA_AUTO_CREATE_TOPICS_ENABLE: 'true'

  # UI để visualize Kafka — rất hữu ích khi debug
  # (provectuslabs/kafka-ui đã ngừng phát triển, kafbat/kafka-ui là bản fork tiếp tục)
  kafka-ui:
    image: ghcr.io/kafbat/kafka-ui:latest
    ports:
      - '8080:8080'
    environment:
      KAFKA_CLUSTERS_0_NAME: local
      KAFKA_CLUSTERS_0_BOOTSTRAPSERVERS: kafka:29092
Chỗ hay vấp nhất với compose kiểu này là ADVERTISED_LISTENERS. Client kết nối lần đầu xong sẽ nhận lại địa chỉ broker "quảng cáo" và gọi tiếp vào địa chỉ đó. Nếu chỉ quảng cáo localhost:9092 thì container kafka-ui sẽ gọi vào localhost của chính nó và không bao giờ kết nối được, nên cần tách listener trong/ngoài như trên.
💡 Tip: dùng KRaft mode (production-ready từ Kafka 3.3) là bỏ được Zookeeper, chạy local dev nhẹ đầu hơn nhiều. Từ Kafka 4.0 (tháng 3/2025), ZooKeeper bị gỡ hẳn, KRaft là lựa chọn duy nhất. Compose trên dùng Confluent Platform 7.5 (Kafka 3.5) nên vẫn chạy được ZooKeeper; dự án mới thì nên đi thẳng KRaft, ví dụ image
apache/kafkachạy một node KRaft với cấu hình mặc định.
# common pitfalls: mấy lỗi tôi từng dính
# consumer rebalance storm
Triệu chứng: consumer cứ join rồi leave group liên tục, không xử lý được message nào.
Nguyên nhân: max.poll.interval.ms quá nhỏ so với thời gian xử lý.
// Sai: xử lý mất 10 phút nhưng max.poll.interval chỉ 5 phút
@KafkaListener(topics = "heavy-processing")
public void handle(Event event) {
    heavyProcessing(event); // Mất 10 phút
    // → Consumer bị kick khỏi group → rebalance → message bị re-deliver
}

// Đúng: max.poll.interval phải lớn hơn (max.poll.records × thời gian xử lý 1 record)
// Ở đây mỗi record mất 10 phút → poll 1 record mỗi lần, interval 15 phút
@KafkaListener(topics = "heavy-processing",
        properties = {
            "max.poll.interval.ms=900000",  // 15 phút
            "max.poll.records=1"             // 1 record mỗi lần poll
        })
public void handle(Event event) {
    heavyProcessing(event);
}
Cái bẫy là max.poll.interval.ms tính cho cả batch của một lần poll chứ không phải từng record. Poll về 500 record, mỗi cái 1 giây là đã hơn 8 phút, vượt mặc định 5 phút. Còn chuyện đẩy việc nặng sang thread pool riêng thì được, nhưng khi đó listener trả về ngay và offset bị commit trước khi xử lý xong; app chết giữa chừng là mất việc. Muốn làm vậy thì phải tự quản lý commit (manual ack sau khi việc xong) hoặc chuyển việc nặng sang một hàng đợi job đúng nghĩa.
# message ordering bị phá vỡ
// Sai: retries có thể làm đảo thứ tự messages
// Message A gửi → fail → retry
// Message B gửi → success
// Message A retry → success
// Kết quả: B trước A → sai thứ tự!

// Đúng: bật idempotence (mặc định bật từ Kafka 3.0), giữ đúng thứ tự
// với max.in.flight.requests.per.connection tối đa 5
spring.kafka.producer.properties.enable.idempotence=true
// Hoặc set max.in.flight.requests.per.connection=1 (nhưng giảm throughput)
# poison pill message
Chỉ cần một message bị hỏng hoặc không deserialize được là consumer kẹt ở đó mãi.
# ✅ Giải pháp: ErrorHandlingDeserializer
spring:
  kafka:
    consumer:
      key-deserializer: org.springframework.kafka.support.serializer.ErrorHandlingDeserializer
      value-deserializer: org.springframework.kafka.support.serializer.ErrorHandlingDeserializer
      properties:
        spring.deserializer.key.delegate.class: org.apache.kafka.common.serialization.StringDeserializer
        spring.deserializer.value.delegate.class: org.springframework.kafka.support.serializer.JsonDeserializer
ErrorHandlingDeserializer bắt lỗi deserialize và chuyển thành DeserializationException cho error handler, thay vì để lỗi nổ ra ngay trong vòng poll. DefaultErrorHandler coi lỗi này là không retry được, nên kết hợp với DeadLetterPublishingRecoverer ở trên thì message hỏng đi thẳng vào DLT, consumer chạy tiếp.
# không set consumer group id
// Không có groupId: Spring lấy spring.kafka.consumer.group-id chung.
// Nếu cũng không có thì consumer lỗi (InvalidGroupIdException) khi subscribe.
// Nhiều listener khác mục đích dùng chung một group cũng là bug khó thấy.
@KafkaListener(topics = "events")

// Luôn set groupId cố định, mỗi mục đích xử lý một group
@KafkaListener(topics = "events", groupId = "my-service")

// Đừng sinh groupId ngẫu nhiên mỗi lần chạy: mỗi lần restart là một group mới,
// không có offset đã commit → đọc lại từ đầu (earliest) hoặc bỏ lỡ message (latest)
# topic partition count không thay đổi được (giảm)
Bạn tạo topic với 3 partitions.
Traffic tăng → bạn tăng lên 12 partitions. OK.
Traffic giảm → bạn muốn giảm về 6 partitions. KHÔNG ĐƯỢC.

→ Plan ahead. Bắt đầu với số partitions hợp lý.
→ Nếu cần giảm: tạo topic mới, migrate data.
# schema evolution: khi event thay đổi
Hệ thống lớn dần thì kiểu gì bạn cũng gặp chuyện này. Event schema đổi theo thời gian, mà consumer cũ thì vẫn phải đọc được.
// Version 1: OrderEvent ban đầu
{
    "orderId": "abc-123",
    "amount": 99.99
}

// Version 2: Thêm field mới (consumer cũ vẫn đọc được ✅)
{
    "orderId": "abc-123",
    "amount": 99.99,
    "currency": "USD"    // Mới — consumer cũ bỏ qua field này (nếu deserializer không fail on unknown)
}

// Version 3: Đổi tên field (BREAKING CHANGE ❌)
{
    "orderId": "abc-123",
    "totalAmount": 99.99  // Consumer cũ tìm "amount" → null
}
Best practices:
- Chỉ thêm field mới (nhớ có default value)
- Không xoá, không đổi tên field
- Lên production thì dùng Apache Avro + Schema Registry
"Consumer cũ bỏ qua field lạ" không phải tự nhiên mà có. JsonDeserializer của Spring Kafka tắt FAIL_ON_UNKNOWN_PROPERTIES sẵn, nhưng một ObjectMapper Jackson 2 tạo tay thì mặc định sẽ ném lỗi khi gặp field không biết, và version 2 ở trên lập tức thành breaking change. Schema Registry giải quyết chuyện này ở tầng hạ tầng: mỗi lần đăng ký schema mới, registry kiểm tra nó có tương thích với schema cũ theo mode đã chọn (mặc định BACKWARD) không, sai là chặn từ lúc deploy producer. Thêm field có default thì qua; đổi tên field thì bị chặn.
// Avro schema evolution với Spring
// (KafkaAvroSerializer nằm trong io.confluent:kafka-avro-serializer, repo Maven của Confluent)
@Configuration
public class AvroConfig {

    @Bean
    public ProducerFactory<String, GenericRecord> avroProducerFactory() {
        Map<String, Object> props = new HashMap<>();
        props.put(ProducerConfig.BOOTSTRAP_SERVERS_CONFIG, "localhost:9092");
        props.put(ProducerConfig.KEY_SERIALIZER_CLASS_CONFIG,
                StringSerializer.class);
        props.put(ProducerConfig.VALUE_SERIALIZER_CLASS_CONFIG,
                KafkaAvroSerializer.class);
        props.put("schema.registry.url", "http://localhost:8081");
        return new DefaultKafkaProducerFactory<>(props);
    }
}
# khi nào KHÔNG nên dùng Kafka?
Kafka không phải thuốc chữa bách bệnh. Mấy trường hợp sau thì đừng dùng:
- Request-response đơn giản: REST/gRPC gọn hơn nhiều
- Ít data, ít traffic: công vận hành Kafka không đáng
- Cần exactly-once delivery mà muốn đơn giản: Kafka có hỗ trợ nhưng làm khá rối
- Chat/notification real-time: WebSocket + Redis Pub/Sub hợp hơn
- Chỉ chạy batch processing: Spark/Flink đọc thẳng từ storage được
Nên dùng Kafka khi:
- Nhiều service cần đọc chung một luồng events
- Cần replay hoặc audit trail
- High throughput (>10K msg/s)
- Event-driven architecture
- Decoupling services trong microservices
# kết luận
Kafka Cheat Sheet:

Topic      = Logical channel cho messages
Partition  = Unit of parallelism & ordering
Offset     = Position của message trong partition
Broker     = Kafka server instance
Consumer Group = Nhóm consumers chia nhau partitions
ISR        = In-Sync Replicas — đảm bảo durability

Producer: acks=all + idempotence=true + min.insync.replicas=2 (RF=3) → không mất data
Consumer: idempotent processing + DLT → không sợ failures
Partition key: cùng key = cùng partition = ordering guarantee
Kafka làm được nhiều thứ, nhưng đổi lại là độ phức tạp đi kèm. Cứ bắt đầu nhỏ thôi: một producer, một consumer, một topic. Hiểu chắc từng khái niệm rồi hẵng scale.
Và nhớ giùm tôi: Kafka không phải message queue. Kafka là distributed commit log. Thấm được câu này thì mấy thứ còn lại tự nhiên sẽ thông.
Chỉ là những ghi chép cá nhân với hy vọng mang lại chút giá trị. Nếu thấy hữu ích, đừng ngại chia sẻ cho bạn bè & đồng nghiệp nhé!
Happy coding 😎 👍🏻 🚀 🔥.