Welcome to MikeDaDev's Blog – notes on Java, backend & system design.

Explore
MikeDaDev's Blog

#ai

Things I've written about #ai
  • Claude Code template cho Spring Boot: mổ xẻ repo của Piotr Mińkowski

    Repo claude-ai-spring-boot gói sẵn CLAUDE.md, 6 agent và 7 skill để Claude Code viết Spring Boot 4 theo đúng chuẩn. Bài này mở từng phần ra xem nó vận hành thế nào, rồi chạy thử code mẫu trong skill trên Spring Boot 4.1.1: chỗ nào compile không qua, chỗ nào Kubernetes sẽ âm thầm bỏ qua preStop hook, file quyền nào đi theo khi clone, và cách sửa trước khi đem về dùng cho team.
  • 12 tính năng Claude Code mà kỹ sư nào cũng nên biết

    Nhiều người dùng Claude Code mỗi ngày mà chỉ xài mỗi ô chat. 12 tính năng dưới đây được giải thích theo đúng cách chúng vận hành bên dưới: CLAUDE.md được nạp ra sao, vì sao context là tài nguyên quý nhất, plan mode, các chế độ quyền, checkpoint, skills chỉ nạp khi cần, subagent cô lập context, hooks và ý nghĩa của exit code 2, MCP, chạy headless trong CI, chạy song song và lên lịch tự động.

  • in ai / llm

    Netflix dạy LLM gợi ý phim để bạn xem mãi không dừng

    Từ cuộc thi Netflix Prize một triệu đô năm 2006 tới việc coi lịch sử xem phim như một câu văn và huấn luyện model kiểu LLM để đoán bộ phim tiếp theo. Những gì Netflix đã chia sẻ công khai: hệ thống gợi ý cổ điển và giới hạn của nó, foundation model cho gợi ý, cách đưa vào sản phẩm, GenRec, bài toán đo "hài lòng lâu dài", và những gì một team nhỏ học được từ đó.

  • in ai / llm

    Agentic RAG hoạt động thế nào?

    RAG cổ điển tra cứu một lần rồi trả lời, nên hay trật với câu hỏi cần nhiều bước, nhiều nguồn. Agentic RAG giao việc tra cứu cho một agent biết tự lên kế hoạch, chọn công cụ, chấm kết quả và tìm lại. Mổ xẻ những chỗ RAG cổ điển hỏng, hybrid search với rerank, các bước tiến hoá HyDE, Self-RAG, CRAG, rồi dựng thử một vòng lặp agent, tính chi phí, điểm mặt các kiểu hỏng trong production và cách đánh giá.

  • in ai / llm

    Red teaming LLM: tự tấn công ứng dụng AI của mình trước khi người khác làm

    Phòng thủ chưa từng bị đánh thử thì chỉ là phòng thủ trên giấy. Red teaming ứng dụng LLM của chính mình: các họ kỹ thuật tấn công từ GCG, PAIR, Crescendo tới many-shot và Best-of-N, vì sao phải đo bằng tỉ lệ chứ không phải "lọt hay không", cần chạy bao nhiêu lần, dùng canary để chấm tự động, cạm bẫy khi dùng LLM làm giám khảo, và cách đưa tất cả vào CI.

  • in ai / llm

    Bảo mật LLM cơ bản: vẽ bản đồ mối đe doạ trước khi viết code

    Prompt injection chưa có thuốc chữa, nên câu hỏi đúng không phải "làm sao để model không bị lừa" mà là "bị lừa rồi thì mất gì". Cách làm threat model cho chatbot, RAG và agent: tài sản, kẻ tấn công, ranh giới tin cậy, lethal trifecta, mổ xẻ vụ EchoLeak trong Microsoft 365 Copilot, và những kiến trúc như CaMeL hay Rule of Two giúp giới hạn thiệt hại ngay từ thiết kế.

  • in ai / llm

    Vì sao LLM cứ đồng ý với bạn, kể cả khi bạn sai?

    Bạn hỏi lại một câu "chắc chưa?", model xin lỗi rồi đổi luôn đáp án đúng thành sai. Tật này có tên là sycophancy. Bài này mổ xẻ nó từ gốc: reward model học khẩu vị con người ra sao, vì sao tối ưu càng mạnh thì càng nịnh, sự cố GPT-4o năm 2025, các phòng lab đo và chữa nó thế nào, và cách hỏi để AI chịu cãi lại bạn.

  • in ai / llm

    The best local LLM models free to run in 2026

    Máy mình thế này thì chạy model nào? Bài này giải thích cách đọc thông số (tham số, MoE, quantization, VRAM) trước khi tải, gợi ý model theo phần cứng từ laptop 8GB tới máy 64GB, điểm qua Qwen 3.5/3.6/3.8, Gemma 4, gpt-oss, Muse Glimmer, Nemotron, và chỉ cách chạy bằng Ollama rồi gọi từ code.

  • in ai / llm

    Chuyện gì xảy ra bên dưới khi bạn prompt xong và nhấn Enter?

    Theo chân một prompt từ lúc bạn nhấn Enter tới khi chữ đầu tiên hiện lên: ghép system prompt, tokenize, xếp hàng chờ GPU, prefill, decode, KV cache, sampling, streaming. Nắm được luồng này là hiểu vì sao output đắt hơn input, vì sao context dài lại chậm, và nên tối ưu chi phí ở đâu.

  • Herdr là gì? Quản lý cả team AI Agent trong một cửa sổ

    Herdr là một terminal multiplexer viết bằng Rust, làm riêng cho dân chạy AI coding agent: liếc một cái là biết agent nào đang chạy, agent nào đang đứng chờ mình duyệt, rớt SSH cũng không mất việc, lại còn cho agent điều khiển agent khác qua CLI. Bài này đi từ cơ bản cho người mới tới kiến trúc, cách Herdr đoán trạng thái agent, viết script điều phối và mấy kinh nghiệm khi chạy nhiều agent cùng lúc.

  • in ai / llm

    How LLMs work? LLM thật ra hoạt động thế nào

    Mổ xẻ LLM từ con số 0: token là gì, embedding là gì, attention làm gì, model được dạy ra sao, và vì sao nó trả lời trơn tru mà thỉnh thoảng vẫn bịa như thật. Người mới đọc để hiểu bản chất, dân làm AI đọc để ôn lại cho có hệ thống.

  • xây dựng đội nhân viên AI cho team IT

    Dựng một đội agent AI đóng vai Developer, PM, QC, DevOps, ngày nào cũng tự chạy trên một máy luôn bật, bạn không cần ngồi canh. Bước nào cũng có script, copy về là chạy được.

  • Spring AI: Dynamic Tool Calling

    Dynamic Tool Calling trong Spring AI: bài toán chi phí token khi nhét hết tool vào Context Window, cách viết CallAdvisor để chọn tool theo ngữ nghĩa qua Vector Store, và cách tự động lập chỉ mục các @Tool bean.

  • jev engineering: make ai intelligent more like human

    Sao phải đốt tiền gọi LLM cồng kềnh chỉ để kiểm tra một điều kiện Boolean? Bài này nói về Jev Engineering: mô hình AI System 1 phi tự hồi quy (Non-autoregressive), rẽ nhánh theo ngữ nghĩa với độ trễ cỡ 70-500ms, rẻ hơn LLM nhiều lần theo công bố của TypeSafe, và đầu ra luôn đúng kiểu.

  • in ai / llmops

    llm evaluation & observability

    Đưa AI lên production rồi thì đo độ chính xác và theo dõi nó kiểu gì? LLM-as-a-Judge, RAG Triad (Context Relevance, Faithfulness, Answer Relevance), Prompt Drift và tracing đầu cuối với Langfuse & OpenTelemetry.

  • in ai / rag

    RAG vs Fine-tuning

    Khi nào nên dùng RAG, khi nào nên Fine-tuning? Hiểu sai hai cách này là có thể đốt cả trăm ngàn USD tiền GPU. Mô hình "nhớ" kiến thức ra sao, 7 trục đánh đổi khi chọn kiến trúc, bài toán TCO và cách ghép RAG với một SLM fine-tune riêng để chạy production.

  • bảo mật LLM & OWASP Top 10

    Bảo mật cho hệ thống Generative AI và Agentic Workflows: vì sao Code Plane và Data Plane lẫn vào nhau trong LLM, các kiểu tấn công theo OWASP Top 10 for LLM, mô hình Dual-LLM Sandbox, Zero-Trust Tool Broker và Guardrails nhiều lớp (Defense-in-Depth) cho production.

  • in ai / slm

    Small Language Models (SLM)

    Nhìn Small Language Models (1B - 8B) từ góc độ người làm kiến trúc: tính VRAM và KV-Cache, chọn kiểu lượng tử hoá (AWQ hay GGUF), chạy Dynamic Multi-LoRA trên vLLM, ghép SLM với LLM thành Compound AI, và bài toán TCO, ROI.

  • in ai / llm

    reasoning models & test-time compute

    DeepSeek-R1 làm cả ngành AI giật mình vì cho thấy năng lực của model không chỉ tăng nhờ pre-training mà còn nhờ cho model nghĩ lâu hơn lúc suy luận (test-time compute). Bài này nói về chuyện đó: scaling law, cách DeepSeek dùng Reinforcement Learning với GRPO, kiến trúc MoE/MLA, và dev phần mềm rút ra được gì.

  • in ai / agent

    langgraph & stateful multi-agent

    Vì sao Chain tuyến tính (DAG) không đủ cho AI Agent phức tạp? Bài này nói về kiến trúc LangGraph, tư duy State Machine, cơ chế time-travel và mấy mẫu phối hợp multi-agent hay gặp.

  • in ai / llm

    vLLM & PagedAttention

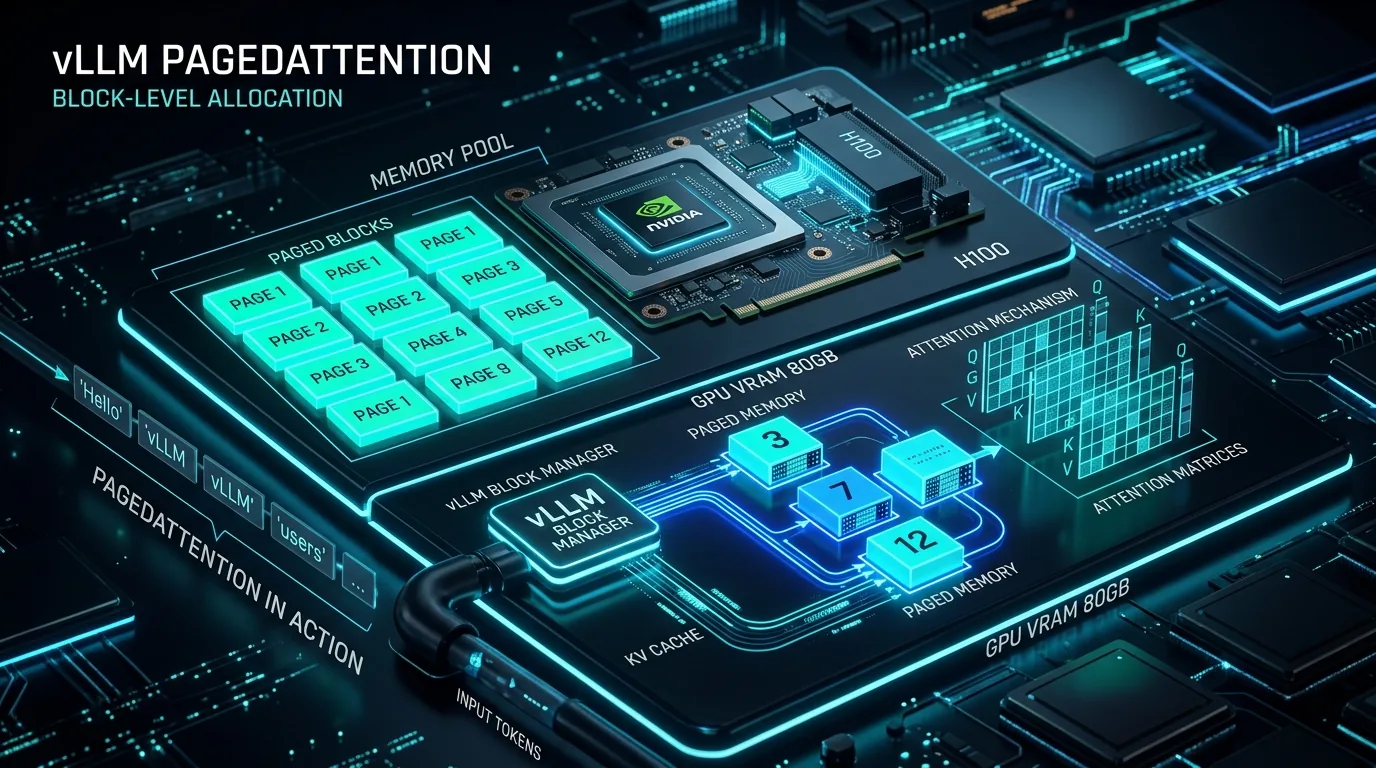
    Model chỉ nặng vài chục GB mà GPU cứ báo hết VRAM? Thủ phạm là KV Cache. Bài này mổ xẻ chuyện KV Cache phình to, cách PagedAttention mượn ý tưởng bộ nhớ ảo của hệ điều hành để xử lý nó, và vì sao vLLM đẩy throughput suy luận lên cao gấp nhiều lần (tới 24 lần so với HuggingFace Transformers, theo số đo của nhóm tác giả).

  • kỹ sư phần mềm trong kỷ nguyên AI

    AI viết 1.000 dòng code trong vài giây, vậy giá trị thật của một Software Engineer còn nằm ở đâu? Bài này nói về nghịch lý năng suất, cái bẫy mai một kỹ năng, chuyện review code ngày càng quá tải và cách tự định vị lại bản thân để không bị thay thế.

  • in ai / rag

    graph rag & advanced rag

    Vì sao vector search kiểu truyền thống bó tay trước câu hỏi nhiều bước (multi-hop)? Bài này mổ xẻ kiến trúc GraphRAG, cách kết hợp Knowledge Graph với Hybrid Search để đưa hệ thống RAG lên mức dùng được cho doanh nghiệp.

  • in ai / n8n

    AI agent workflows với n8n

    Từ chỗ viết cả trăm dòng code nối API tới chỗ dựng hẳn một hệ thống AI Agent tự động hoá. Bài này đi qua kiến trúc AI Agent trong n8n, LangChain node, Vector Store, Tool Calling và mấy kinh nghiệm khi đưa lên production.

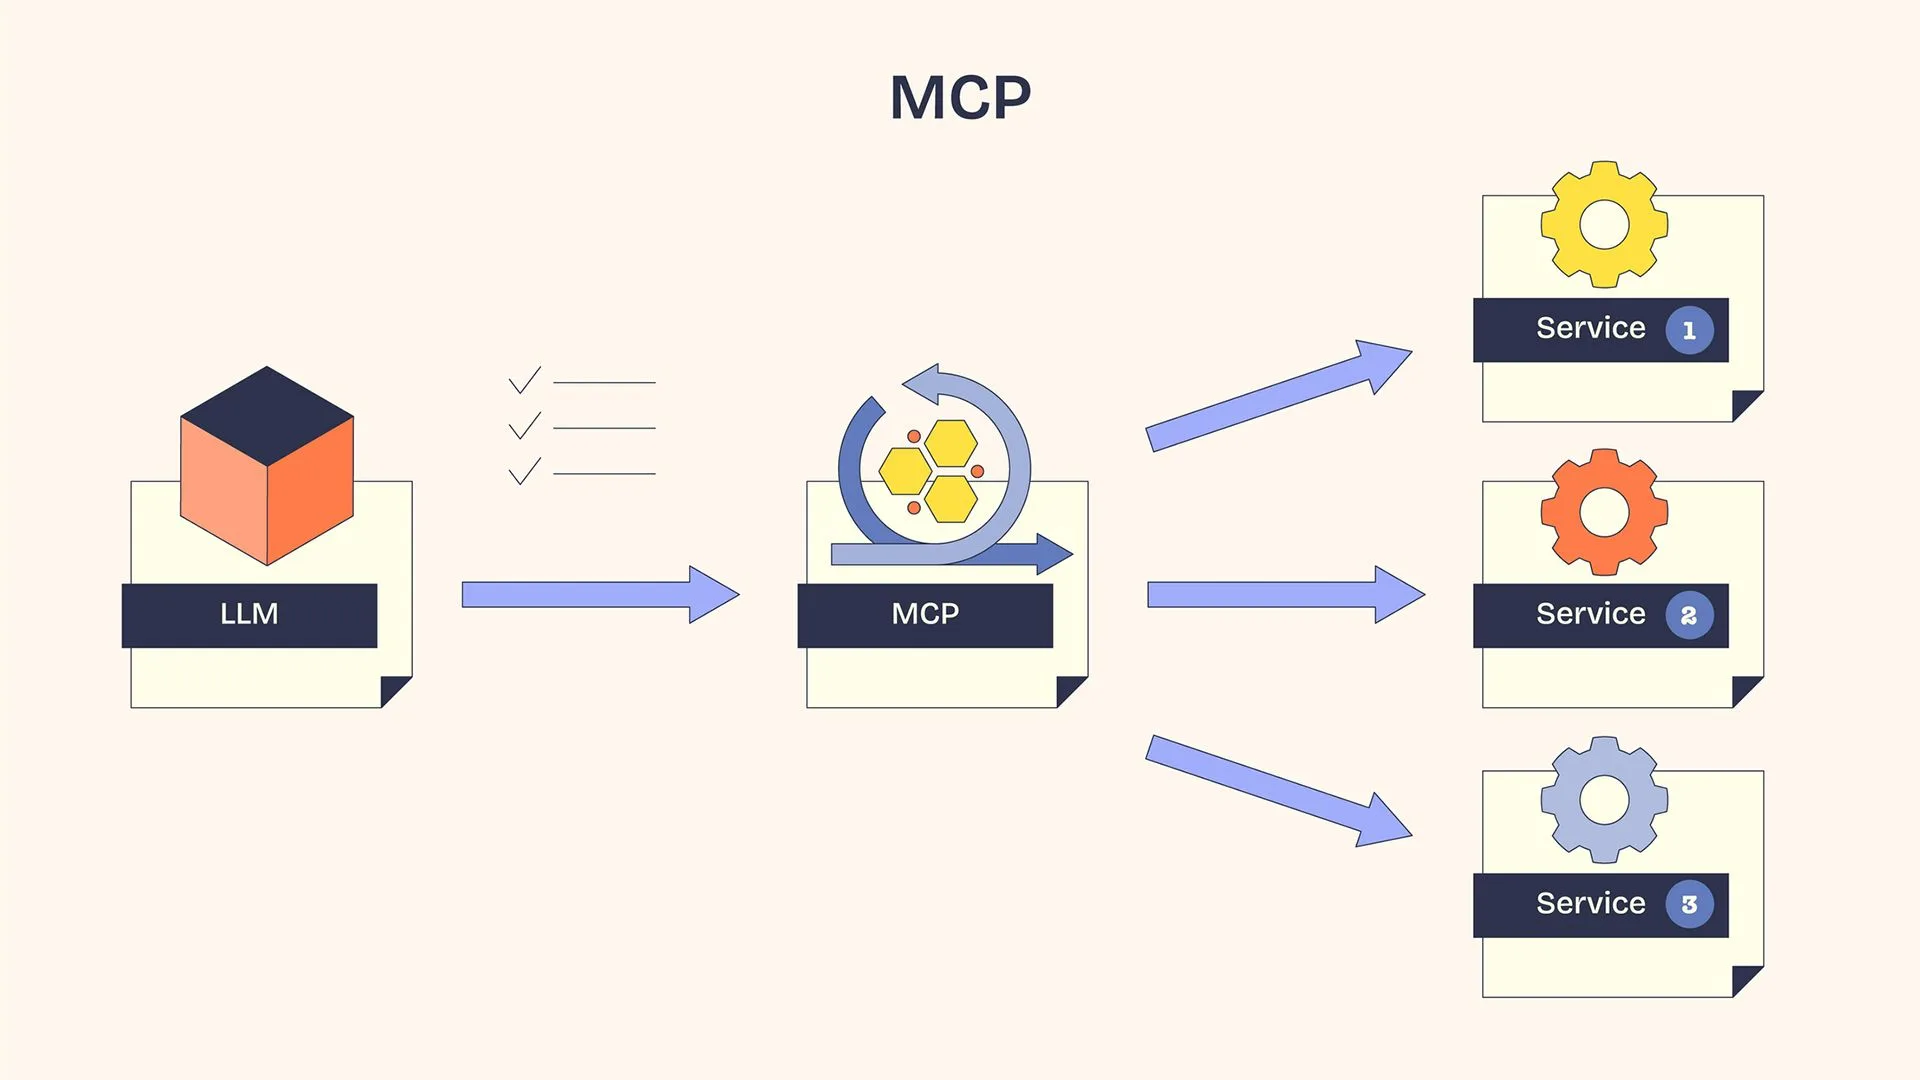
  • model context protocol

    Model Context Protocol (MCP) là một chuẩn mở giúp trợ lý AI kết nối thẳng và an toàn tới nguồn dữ liệu, API hay môi trường làm việc bên ngoài. Có một giao thức chung như vậy, AI đọc được ngữ cảnh của người dùng mà không cần ai ngồi viết connector riêng cho từng ứng dụng.

  • ai agentic systems

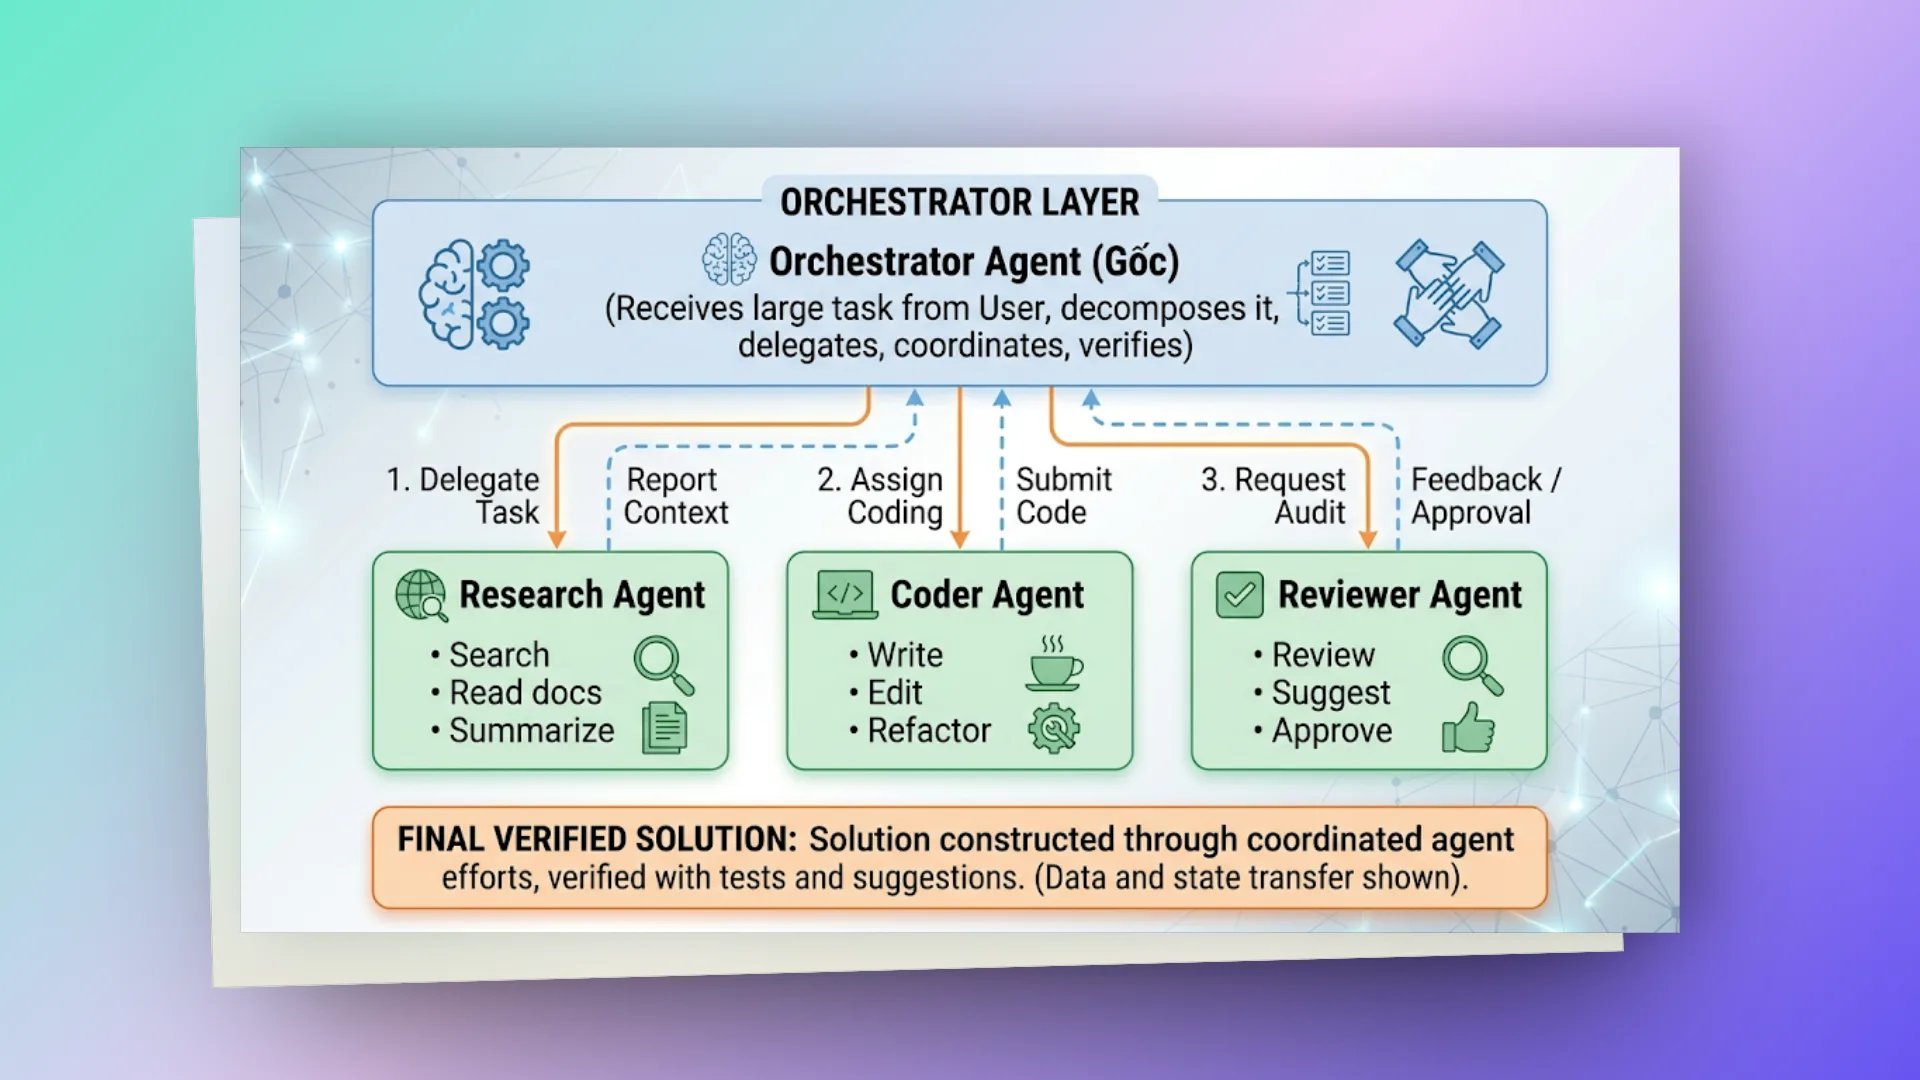
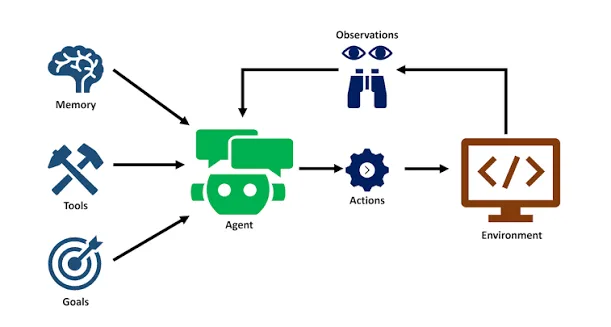
    AI agent là bước chuyển lớn của AI: từ chatbot thụ động chỉ biết "hỏi - đáp" sang những "nhân viên số" tự lên kế hoạch, tự hành động để giải quyết việc phức tạp. Bài này đi qua cấu tạo của agent, vòng lặp ReAct, cách lập kế hoạch, multi-agent và mấy kinh nghiệm khi xây agent.