Welcome to MikeDaDev's Blog – notes on Java, backend & system design.

Explore
MikeDaDev's Blog

#llm

Things I've written about #llm
  • in ai / llm

    Netflix dạy LLM gợi ý phim để bạn xem mãi không dừng

    Từ cuộc thi Netflix Prize một triệu đô năm 2006 tới việc coi lịch sử xem phim như một câu văn và huấn luyện model kiểu LLM để đoán bộ phim tiếp theo. Những gì Netflix đã chia sẻ công khai: hệ thống gợi ý cổ điển và giới hạn của nó, foundation model cho gợi ý, cách đưa vào sản phẩm, GenRec, bài toán đo "hài lòng lâu dài", và những gì một team nhỏ học được từ đó.
  • in ai / llm

    Agentic RAG hoạt động thế nào?

    RAG cổ điển tra cứu một lần rồi trả lời, nên hay trật với câu hỏi cần nhiều bước, nhiều nguồn. Agentic RAG giao việc tra cứu cho một agent biết tự lên kế hoạch, chọn công cụ, chấm kết quả và tìm lại. Mổ xẻ những chỗ RAG cổ điển hỏng, hybrid search với rerank, các bước tiến hoá HyDE, Self-RAG, CRAG, rồi dựng thử một vòng lặp agent, tính chi phí, điểm mặt các kiểu hỏng trong production và cách đánh giá.

  • in ai / llm

    Red teaming LLM: tự tấn công ứng dụng AI của mình trước khi người khác làm

    Phòng thủ chưa từng bị đánh thử thì chỉ là phòng thủ trên giấy. Red teaming ứng dụng LLM của chính mình: các họ kỹ thuật tấn công từ GCG, PAIR, Crescendo tới many-shot và Best-of-N, vì sao phải đo bằng tỉ lệ chứ không phải "lọt hay không", cần chạy bao nhiêu lần, dùng canary để chấm tự động, cạm bẫy khi dùng LLM làm giám khảo, và cách đưa tất cả vào CI.

  • in ai / llm

    Bảo mật LLM cơ bản: vẽ bản đồ mối đe doạ trước khi viết code

    Prompt injection chưa có thuốc chữa, nên câu hỏi đúng không phải "làm sao để model không bị lừa" mà là "bị lừa rồi thì mất gì". Cách làm threat model cho chatbot, RAG và agent: tài sản, kẻ tấn công, ranh giới tin cậy, lethal trifecta, mổ xẻ vụ EchoLeak trong Microsoft 365 Copilot, và những kiến trúc như CaMeL hay Rule of Two giúp giới hạn thiệt hại ngay từ thiết kế.

  • in ai / llm

    Vì sao LLM cứ đồng ý với bạn, kể cả khi bạn sai?

    Bạn hỏi lại một câu "chắc chưa?", model xin lỗi rồi đổi luôn đáp án đúng thành sai. Tật này có tên là sycophancy. Bài này mổ xẻ nó từ gốc: reward model học khẩu vị con người ra sao, vì sao tối ưu càng mạnh thì càng nịnh, sự cố GPT-4o năm 2025, các phòng lab đo và chữa nó thế nào, và cách hỏi để AI chịu cãi lại bạn.

  • in ai / llm

    The best local LLM models free to run in 2026

    Máy mình thế này thì chạy model nào? Bài này giải thích cách đọc thông số (tham số, MoE, quantization, VRAM) trước khi tải, gợi ý model theo phần cứng từ laptop 8GB tới máy 64GB, điểm qua Qwen 3.5/3.6/3.8, Gemma 4, gpt-oss, Muse Glimmer, Nemotron, và chỉ cách chạy bằng Ollama rồi gọi từ code.

  • in ai / llm

    Chuyện gì xảy ra bên dưới khi bạn prompt xong và nhấn Enter?

    Theo chân một prompt từ lúc bạn nhấn Enter tới khi chữ đầu tiên hiện lên: ghép system prompt, tokenize, xếp hàng chờ GPU, prefill, decode, KV cache, sampling, streaming. Nắm được luồng này là hiểu vì sao output đắt hơn input, vì sao context dài lại chậm, và nên tối ưu chi phí ở đâu.

  • in ai / llm

    How LLMs work? LLM thật ra hoạt động thế nào

    Mổ xẻ LLM từ con số 0: token là gì, embedding là gì, attention làm gì, model được dạy ra sao, và vì sao nó trả lời trơn tru mà thỉnh thoảng vẫn bịa như thật. Người mới đọc để hiểu bản chất, dân làm AI đọc để ôn lại cho có hệ thống.

  • Spring AI: Dynamic Tool Calling

    Dynamic Tool Calling trong Spring AI: bài toán chi phí token khi nhét hết tool vào Context Window, cách viết CallAdvisor để chọn tool theo ngữ nghĩa qua Vector Store, và cách tự động lập chỉ mục các @Tool bean.

  • bảo mật LLM & OWASP Top 10

    Bảo mật cho hệ thống Generative AI và Agentic Workflows: vì sao Code Plane và Data Plane lẫn vào nhau trong LLM, các kiểu tấn công theo OWASP Top 10 for LLM, mô hình Dual-LLM Sandbox, Zero-Trust Tool Broker và Guardrails nhiều lớp (Defense-in-Depth) cho production.

  • in ai / llm

    reasoning models & test-time compute

    DeepSeek-R1 làm cả ngành AI giật mình vì cho thấy năng lực của model không chỉ tăng nhờ pre-training mà còn nhờ cho model nghĩ lâu hơn lúc suy luận (test-time compute). Bài này nói về chuyện đó: scaling law, cách DeepSeek dùng Reinforcement Learning với GRPO, kiến trúc MoE/MLA, và dev phần mềm rút ra được gì.

  • in ai / llm

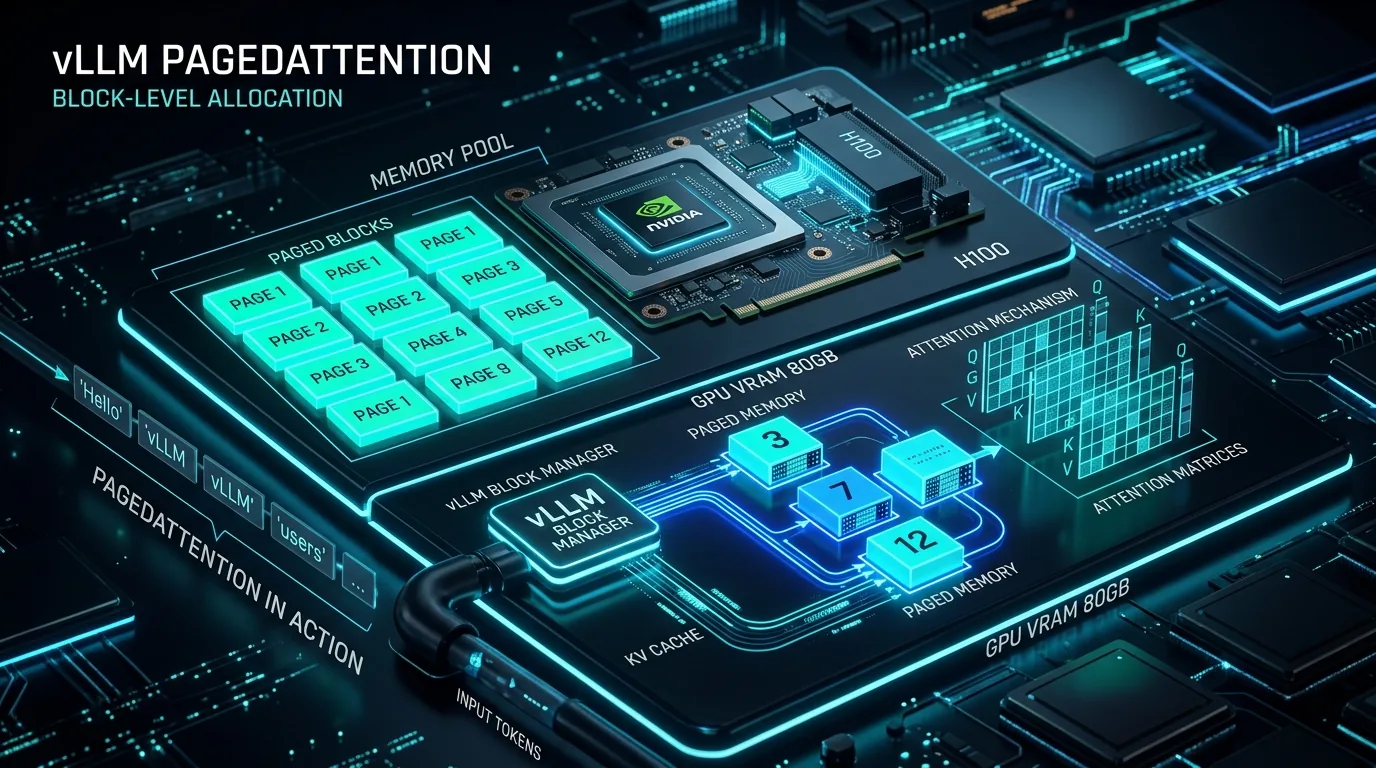
    vLLM & PagedAttention

    Model chỉ nặng vài chục GB mà GPU cứ báo hết VRAM? Thủ phạm là KV Cache. Bài này mổ xẻ chuyện KV Cache phình to, cách PagedAttention mượn ý tưởng bộ nhớ ảo của hệ điều hành để xử lý nó, và vì sao vLLM đẩy throughput suy luận lên cao gấp nhiều lần (tới 24 lần so với HuggingFace Transformers, theo số đo của nhóm tác giả).

  • in ai / rag

    graph rag & advanced rag

    Vì sao vector search kiểu truyền thống bó tay trước câu hỏi nhiều bước (multi-hop)? Bài này mổ xẻ kiến trúc GraphRAG, cách kết hợp Knowledge Graph với Hybrid Search để đưa hệ thống RAG lên mức dùng được cho doanh nghiệp.

  • spring ai và kiến trúc rag

    Mổ kiến trúc Spring AI 1.x: ChatClient Fluent API, chuỗi Advisors, RAG với VectorStore và PgVector, Function Calling, Observability với Micrometer/OpenTelemetry và mấy pattern resilience để sống sót qua rate-limit.