Distributed Tracing với Micrometer & OpenTelemetry
Tung Bui Thanh (TungDaDev) (updated 3 weeks ago)14 mins read
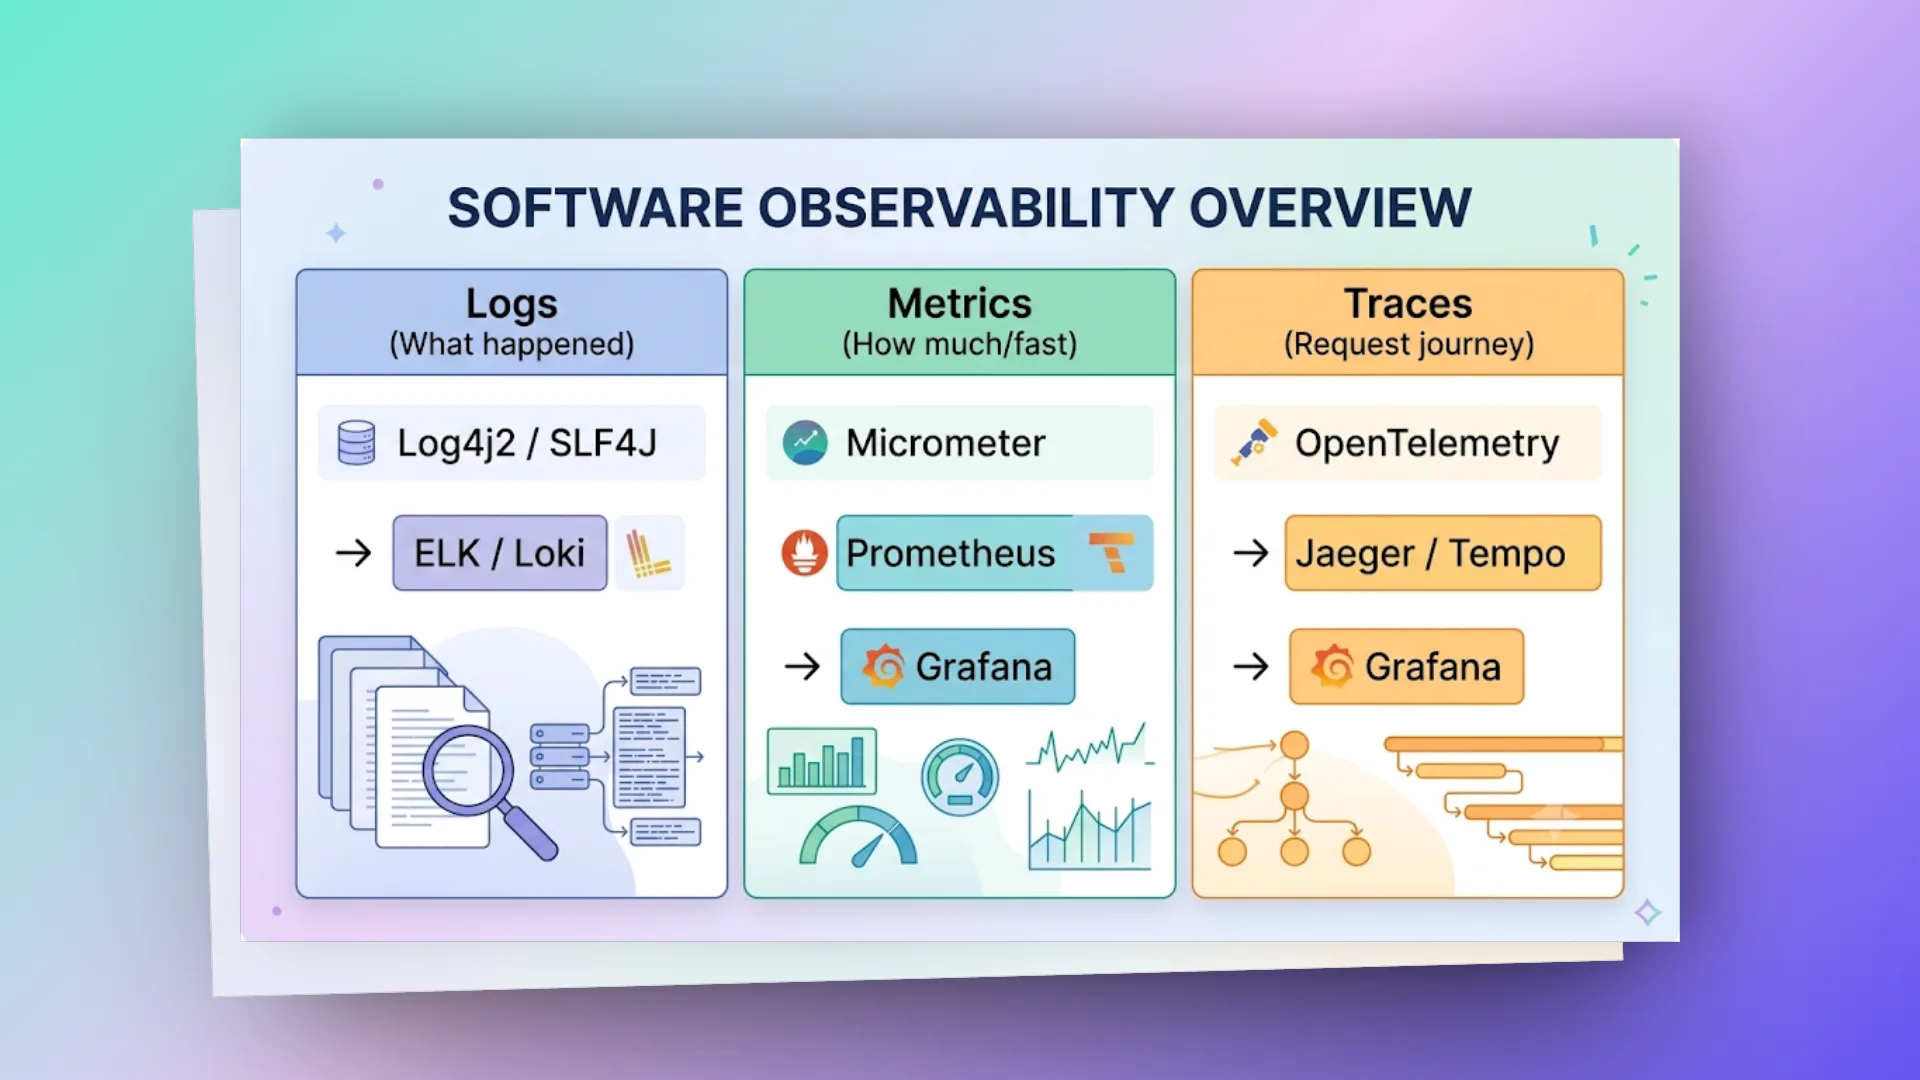
Với Monolith truyền thống, điều tra sự cố (Root Cause Analysis) khá trực quan: mở một file log duy nhất rồi lần theo Stack Trace từ dòng ném exception ngược lên điểm xuất phát.
Sang Microservices với hàng chục, hàng trăm service thì khác. Một thao tác nhìn rất đơn giản của người dùng (bấm nút "Đặt hàng") có thể kéo theo cả chuỗi phản ứng dây chuyền:
API Gateway→ 2.Auth Service(xác thực JWT) → 3.Order Service(tạo đơn hàng) → 4.Inventory Service(khoá tồn kho) → 5. bắn sự kiện sangKafka→ 6.Payment Service(gọi cổng thanh toán bên thứ ba) → 7.Notification Service(gửi SMS/Email).
Rồi một hôm khách phản ánh: "Bấm Đặt hàng thì quay vòng gần 10 giây mới xong, tiền bị trừ rồi mà mãi không thấy SMS xác nhận!" Câu phàn nàn này thật ra chứa hai sự cố. Phần quay vòng nằm ở đoạn đồng bộ từ bước 1 tới bước 5, người dùng phải chờ đoạn này xong mới thấy kết quả. Còn chuyện thanh toán và SMS diễn ra sau Kafka, chạy bất đồng bộ, người dùng không chờ nhưng vẫn có thể hỏng ở đâu đó. Mỗi service ghi hàng chục nghìn dòng log mỗi giây thì bạn làm gì? Làm sao biết dòng log nào ở Payment Service thuộc đúng đơn hàng đó? Và khâu nào trong chuỗi đồng bộ đã ngốn gần 10 giây?
Distributed Tracing trả lời đúng hai câu đó: gắn cho mỗi request một mã định danh đi xuyên qua mọi service, và ghi lại mỗi bước tốn bao lâu.
Sang Spring Boot 3, Spring Cloud Sleuth đã ngừng phát triển: nhánh 3.1 là bản cuối và không chạy với Spring Boot 3. Phần lõi của nó được tách ra thành Micrometer Tracing, đi cùng chuẩn mở OpenTelemetry (OTel).
Bài này đi qua kiến trúc Distributed Tracing cho production: đặc tả W3C Trace Context, cách giữ context khi đổi thread hoặc đi qua Kafka, và chiến lược lấy mẫu Tail-Based Sampling với OpenTelemetry Collector.
# trace, span & w3c trace context
Hai khái niệm cần nắm trước. Trace là toàn bộ hành trình của một request qua hệ thống. Span là một bước trong hành trình đó (một lần xử lý HTTP, một câu SQL, một lần gửi message), có thời điểm bắt đầu, kết thúc và trỏ tới span cha. Ghép các span theo quan hệ cha con, bạn có một cây, và vẽ cây đó theo trục thời gian thì ra biểu đồ waterfall quen thuộc trên Tempo hay Jaeger.
Để cây này nối được qua nhiều ngôn ngữ (Java, Go, Node.js, Python), các service phải thống nhất cách truyền trace ID cho nhau. Đó là việc của đặc tả W3C Trace Context.
Để ý span D: Payment Service nhận việc qua Kafka nên chạy bất đồng bộ, có thể kết thúc sau khi Gateway đã trả response. Nó vẫn nằm trong cùng trace vì trace ID đi theo header của Kafka record.
# cấu trúc header traceparent (W3C Standard)
Khi service này gọi service khác qua HTTP, sẽ có một header đi kèm:
traceparent: 00-4bf92f3577b34da6a3ce929d0e0e4736-00f067aa0ba902b7-01Header này gồm 4 trường, phân cách bằng dấu gạch nối:
version(00): phiên bản đặc tả W3C hiện tại.trace-id(4bf92f3577b34da6a3ce929d0e0e4736): chuỗi hex 16 byte (32 ký tự), định danh duy nhất cho cả hành trình đi qua mọi microservice.parent-id(00f067aa0ba902b7): chuỗi hex 8 byte (16 ký tự), là span ID của bên gọi. Phía nhận tạo span mới của mình và lấy giá trị này làm span cha.trace-flags(01): bitmask. Bit thấp nhất bật (01) nghĩa là bên gọi đã quyết định lấy mẫu trace này (sampled). Phần lớn tracer cấu hình mặc định kiểu "parent-based", tức downstream làm theo quyết định đó, nhờ vậy một trace hoặc được ghi đủ, hoặc bỏ hẳn, không bị thủng lỗ chỗ.
# baggage: lan truyền metadata nghiệp vụ
Ngoài traceparent, W3C còn có header baggage. Bạn gắn metadata không nhạy cảm (ví dụ: tenant_id=enterprise-vn, client_version=2.4.1) ở Gateway, và dữ liệu này đi theo request sang các service phía sau mà không cần thêm tham số vào hàm Java.
Hai lưu ý. Với Micrometer Tracing, chỉ những field khai báo trong management.tracing.baggage.remote-fields mới được gửi đi và nhận vào (xem cấu hình bên dưới). Và baggage là header plain text gửi kèm mọi lời gọi ra ngoài, kể cả gọi sang bên thứ ba nếu bạn không chặn, nên đừng bỏ email, token hay dữ liệu cá nhân vào đây.
# kiến trúc micrometer tracing: facade trong spring boot 3
Ở Spring Boot 2, Spring Cloud Sleuth gắn chặt với thư viện Brave của Zipkin.
Spring Boot 3 thiết kế lại theo mô hình Facade, giống SLF4J với logging: code của bạn và của framework chỉ nói chuyện với API của Micrometer, còn bên dưới cắm OpenTelemetry hay Brave tuỳ chọn qua "bridge". Đổi tracer thì đổi dependency, không phải sửa code.
Observation API là chỗ đáng chú ý nhất: framework bọc mỗi thao tác (một HTTP request, một lần gửi Kafka) trong một Observation, và từ đó Micrometer sinh ra cả metric (đếm, đo thời gian) lẫn span. Bạn không phải đo hai lần cho hai hệ thống.
# cấu hình production: spring boot 3 + otlp + grafana tempo
# khai báo dependencies (pom.xml)
<dependencies>
    <!-- 1. Spring Boot Actuator: Nền tảng quản trị và đo lường -->
    <dependency>
        <groupId>org.springframework.boot</groupId>
        <artifactId>spring-boot-starter-actuator</artifactId>
    </dependency>

    <!-- 2. Cầu nối Micrometer sang OpenTelemetry -->
    <dependency>
        <groupId>io.micrometer</groupId>
        <artifactId>micrometer-tracing-bridge-otel</artifactId>
    </dependency>

    <!-- 3. Exporter OTLP: Đẩy spans sang OpenTelemetry Collector / Tempo -->
    <dependency>
        <groupId>io.opentelemetry</groupId>
        <artifactId>opentelemetry-exporter-otlp</artifactId>
    </dependency>
</dependencies>
Endpoint prometheus trong cấu hình dưới cần thêm micrometer-registry-prometheus, không liên quan tới tracing.
# cấu hình application.yml
management:
  endpoints:
    web:
      exposure:
        include: health, info, metrics, prometheus
  tracing:
    sampling:
      probability: 0.1 # Trên Production: Lấy mẫu 10% để tối ưu tài nguyên (Dev để 1.0)
    propagation:
      type: W3C # Bắt buộc tuân thủ chuẩn W3C
    baggage:
      remote-fields: 'tenant_id,workspace_id' # Cho phép lan truyền các header này
      correlation:
        fields: 'tenant_id' # Tự động nhét tenant_id vào log MDC!
  otlp:
    tracing:
      endpoint: 'http://otel-collector:4318/v1/traces' # Đẩy qua OTLP HTTP
      timeout: 2000ms

# Định dạng Log Correlation tự động gắn TraceId và SpanId
logging:
  pattern:
    level: '%5p [${spring.application.name:backend-service},%X{traceId:-},%X{spanId:-},%X{tenant_id:-}]'
Vài điểm trong file này dễ hiểu nhầm:
probabilitymặc định của Spring Boot đã là0.1, vàW3Ccũng là kiểu propagation mặc định. Ghi rõ ra cho người đọc config sau này đỡ phải đoán.- Cổng
4318là OTLP qua HTTP,4317là OTLP qua gRPC. Spring Boot 3 mặc định dùng HTTP, nên URL phải có đủ đường dẫn/v1/traces. - Từ Spring Boot 3.2, khi có tracing, Boot đã tự chèn
[app,traceId,spanId]vào log qualogging.pattern.correlation. Ghi đèlogging.pattern.levelnhư trên vẫn chạy, nhưng có thể bị lặp ID hai lần trên một dòng log. Nếu chỉ cần thêmtenant_id, sửalogging.pattern.correlationsẽ gọn hơn. - Spring Boot chỉ gắn tracing vào client nào được tạo từ builder do nó cấu hình sẵn (
RestTemplateBuilder,RestClient.Builder,WebClient.Builder). Tựnew RestTemplate()thì request đi ra không có headertraceparent, và trace đứt ngay ở đó.
NOTE
Spring Boot 4 (ra mắt tháng 11/2025) gom phần này vào starter spring-boot-starter-opentelemetry, và nhóm property OTLP chuyển sang management.opentelemetry.tracing.export.otlp.*. Cấu hình trong bài là cho Spring Boot 3.x; nâng cấp thì xem lại tài liệu tracing của Spring Boot.
Trace qua Kafka. Spring Boot không bật observation cho Kafka theo mặc định. Thiếu hai dòng dưới đây thì producer không ghi traceparent vào header của record, consumer không đọc ra, và mũi tên đứt nét từ span C sang span D trong sơ đồ đầu bài sẽ không tồn tại:
spring:
  kafka:
    template:
      observation-enabled: true
    listener:
      observation-enabled: true
# log correlation: nối loki với tempo
Một tính năng rất hữu ích của Distributed Tracing là Log Correlation:
- Khi có request đến, Micrometer tự đưa
traceIdvàspanIdvào MDC (Mapped Diagnostic Context) của SLF4J. MDC hiểu đơn giản là một cái map gắn với thread hiện tại, logger đọc từ đó để in thêm thông tin. - Mọi câu
log.info(...)trong thread đó đều được gắn sẵn các ID này.
2026-09-10 14:20:15.123 INFO [order-service,4bf92f3577b34da6a3ce929d0e0e4736,5a11c89012abcdef,tenant-vip] : Đang xử lý thanh toán đơn hàng ORD-999Trên Grafana, bạn cấu hình "derived field" cho data source Loki để nhận diện traceId trong dòng log và biến nó thành link sang Tempo. Từ một dòng log lỗi, bấm một cái là thấy cả cây span:
# cạm bẫy đứt context: thread handoff & asynchronous execution
Trong Java, MDC và tracing context nằm trong ThreadLocal, tức là gắn với đúng thread đang chạy.
Nếu code giao việc sang một thread khác, ví dụ:
- Dùng
@Async - Dùng
CompletableFuture.supplyAsync() - Đẩy task sang một virtual thread mới
- Dùng
ExecutorService
thì thread mới không có các giá trị ThreadLocal của thread cũ. Log ở thread con sẽ có traceId rỗng, span tạo ở đó thì thành root của một trace mới, và cây trace bị đứt.
# giải pháp: micrometer context propagation
Thư viện io.micrometer:context-propagation (Spring Boot 3 kéo vào sẵn khi có Micrometer Tracing) chụp lại các ThreadLocal đã đăng ký ở thread gọi, rồi khôi phục chúng ở thread chạy task. Spring Framework 6.1 (Spring Boot 3.2) có sẵn ContextPropagatingTaskDecorator để gắn cơ chế này vào thread pool:
@Configuration
public class AsyncThreadPoolConfig {

    @Bean
    public ThreadPoolTaskExecutor taskExecutor() {
        ThreadPoolTaskExecutor executor = new ThreadPoolTaskExecutor();
        executor.setCorePoolSize(8);
        executor.setMaxPoolSize(16);
        executor.setThreadNamePrefix("async-worker-");

        // KÍCH HOẠT TÍNH NĂNG TỰ ĐỘNG CHUYỂN TIẾP CONTEXT:
        // Khôi phục Observation/Span hiện tại (kéo theo traceId, spanId trong MDC) ở worker thread.
        // SecurityContext chỉ được chuyển theo từ Spring Security 6.5 trở đi.
        executor.setTaskDecorator(new ContextPropagatingTaskDecorator());

        executor.initialize();
        return executor;
    }
}
Mấy chỗ hay sót:
- Decorator chỉ có tác dụng với task đi qua executor này.
CompletableFuture.supplyAsync(task)không truyền executor sẽ chạy trênForkJoinPool.commonPool()và context vẫn mất. Hãy truyền executor vào:supplyAsync(task, taskExecutor). - Tự khai báo bean
ThreadPoolTaskExecutorthì executor mặc định của Spring Boot sẽ lùi lại. Cách khác gọn hơn là chỉ khai báo một beanTaskDecorator(trả vềnew ContextPropagatingTaskDecorator()); Spring Boot 3.2+ tự gắn nó vào executor mà Boot cấu hình cho@Async, kể cả khi bậtspring.threads.virtual.enabled. - Spring Security chỉ đăng ký
SecurityContextHolderThreadLocalAccessortừ bản 6.5. Bản cũ hơn muốn mangSecurityContextsang thread khác thì dùngDelegatingSecurityContextAsyncTaskExecutorhoặc tự đăng ký accessor.
# chiến lược lấy mẫu: head-based vs tail-based sampling
Khi hệ thống xử lý 100,000 requests/giây, thu thập 100% trace sẽ sinh ra hàng terabyte dữ liệu mỗi ngày, làm quá tải hạ tầng mạng và storage của Grafana Tempo. Phải lấy mẫu, câu hỏi là quyết định lấy hay bỏ ở đâu và lúc nào.
Head-based quyết định ngay từ span đầu tiên, lúc chưa ai biết request sẽ lỗi hay chậm. Tail-based thì đợi gom đủ span của một trace rồi mới quyết, nên chọn được đúng những trace đáng xem. Cái giá là Collector phải giữ mọi span trong RAM suốt thời gian chờ.
# vì sao tail-based sampling được SRE ưa chuộng?
Đặt một OpenTelemetry Collector đứng giữa Spring Boot và Grafana Tempo thì:
- 100% request lỗi (Error) hoặc chậm (High Latency) đều được lưu đầy đủ.
- Khoảng 99% trace thành công bình thường bị loại bỏ, tiết kiệm chi phí lưu trữ.
Cấu hình tương ứng dùng processor tail_sampling. Processor này nằm trong bản phân phối otelcol-contrib, không có trong bản core. Các policy được xét theo kiểu "hoặc": trace khớp một policy bất kỳ là được giữ.
processors:
  tail_sampling:
    decision_wait: 30s # chờ 30s kể từ span đầu tiên rồi mới quyết
    num_traces: 100000 # số trace tối đa giữ trong RAM
    policies:
      - name: errors
        type: status_code
        status_code:
          status_codes: [ERROR]
      - name: slow
        type: latency
        latency:
          threshold_ms: 2000
      - name: baseline
        type: probabilistic
        probabilistic:
          sampling_percentage: 1
Hai cạm bẫy khi triển khai:
- Phía ứng dụng phải gửi đủ. Nếu service vẫn để
management.tracing.sampling.probability: 0.1như ví dụ ở trên thì 90% trace đã bị bỏ ngay trong ứng dụng, Collector có thông minh mấy cũng không thấy. Dùng tail-based thì đặtprobability: 1.0và để Collector lọc. - Nhiều Collector thì phải gom span theo trace ID. Tail sampling chỉ đúng khi mọi span của một trace về cùng một instance. Chạy nhiều instance thì đặt một tầng Collector phía trước dùng
loadbalancingexporter để định tuyến theo trace ID.
TIP
Virtual Threads & Context Propagation: bật Virtual Threads (Java 21+, Spring Boot 3.2+ với spring.threads.virtual.enabled=true) không làm context tự đi theo. Mỗi task giao sang virtual thread mới vẫn cần ContextPropagatingTaskDecorator như thread thường. ScopedValue (chính thức từ Java 25) là hướng thay thế ThreadLocal về lâu dài, nhưng hiện Micrometer và Spring vẫn lưu context bằng ThreadLocal, nên chưa dùng nó thay cho decorator được. Với hàng triệu virtual thread, mỗi thread lại giữ một bản sao ThreadLocal, nên giữ context gọn: ít field baggage, không nhét object lớn vào MDC.
# tổng kết & checklist
- Chuẩn hoá W3C: dùng header
traceparentcho mọi giao tiếp REST và Kafka header để Trace ID liền mạch; nhớ bậtobservation-enabledcho Kafka. - Bỏ Sleuth: nâng lên Spring Boot 3 với
micrometer-tracing-bridge-otelđể theo chuẩn OpenTelemetry. - Log Correlation: đưa
traceIdvàspanIdvào pattern log của SLF4J để nối Grafana Loki với Tempo. - Giữ Thread Context: dùng
ContextPropagatingTaskDecoratorkhi giao việc sang thread pool bất đồng bộ, và luôn truyền executor vàoCompletableFuture. - Tail-Based Sampling: dùng OpenTelemetry Collector để không bỏ sót trace lỗi nào trên Production, với điều kiện ứng dụng gửi đủ 100% span về Collector.
Muốn đọc tiếp phần metrics thì xem bài Prometheus và Observability & Monitoring.
Chỉ là những ghi chép cá nhân với hy vọng mang lại chút giá trị. Nếu thấy hữu ích, đừng ngại chia sẻ cho bạn bè & đồng nghiệp nhé!
Happy coding 😎 👍🏻 🚀 🔥.