@OneToMany & @ManyToOne trong JPA
Tung Bui Thanh (TungDaDev) (updated 6 months ago)12 mins read
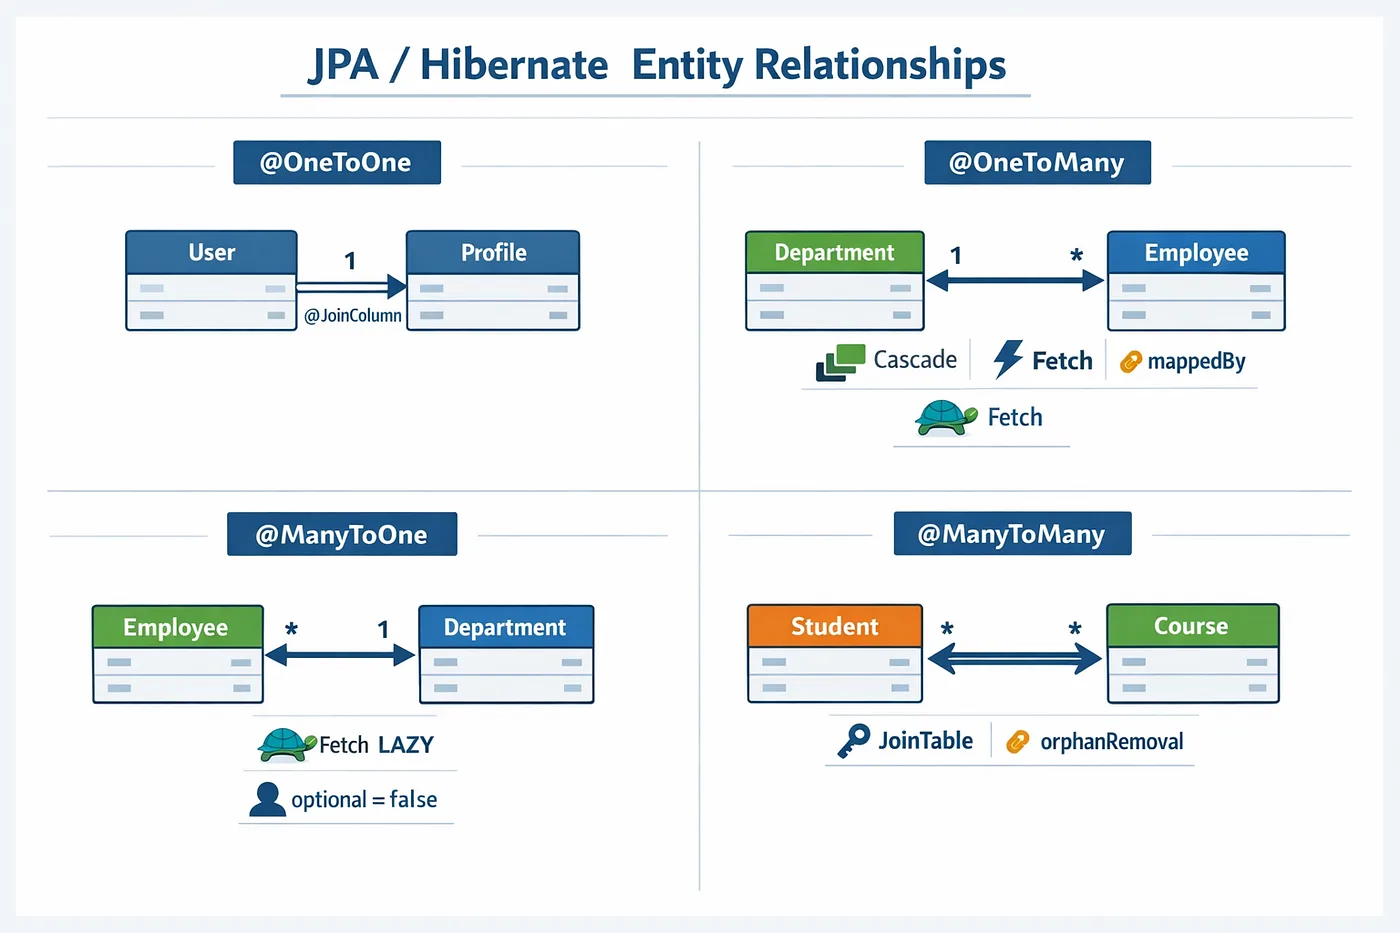
Trong app dùng Spring Data JPA và Hibernate, quan hệ một-nhiều (1-N) xuất hiện ở khắp nơi: một khách hàng có nhiều đơn hàng (Customer -> Orders), một đơn hàng có nhiều dòng sản phẩm (Order -> OrderItems), một phòng ban có nhiều nhân viên (Department -> Employees).
Cũng chính chỗ này là nguồn gốc của rất nhiều sự cố database chậm trên production:
- API lấy danh sách chậm rì vì bắn ra cả nghìn câu query con (N+1 Query Problem).
- Server sập vì tràn Heap khi Hibernate kéo gần hết database lên RAM do Cartesian Product Explosion.
- App crash với
StackOverflowErrorvìtoString()vàhashCode()do Lombok sinh ra gọi nhau vòng vòng. - Hibernate lặng lẽ tạo thêm một bảng phụ (junction table) chẳng ai cần, chỉ vì thiếu
mappedBy.
Bài này gom lại các quy tắc nên theo khi dùng cặp @OneToMany và @ManyToOne trên production.
# owning side và inverse side
Trong RDBMS, bảng ở phía nhiều (Many) luôn là bảng giữ cột khoá ngoại (Foreign Key - FK). Phía một (One) không có cột nào trỏ sang phía nhiều cả.
Trong JPA/Hibernate:
- Owning Side (phía sở hữu quan hệ): luôn là entity phía
@ManyToOne. Nó map thẳng vào cột FK qua@JoinColumn(name = "parent_id"). Mọi thay đổi (gán parent, gỡ parent) chỉ được Hibernate flush xuống DB khi bạn sửa ở owning side. - Inverse / Non-Owning Side (phía bị sở hữu): là entity phía
@OneToMany. Bên này bắt buộc khai báomappedBy = "tên_thuộc_tính_ở_owning_side".
# quên khai báo mappedBy thì sao
Nếu bạn chỉ viết:
@OneToMany(cascade = CascadeType.ALL)
private List<Employee> employees;
Hibernate sẽ hiểu đây là quan hệ Unidirectional One-to-Many, tách biệt hẳn với @ManyToOne bên Employee. Nó tự sinh thêm bảng trung gian department_employees (department_id, employees_id) (tên cột thứ hai lấy theo tên field employees), kèm theo cả loạt INSERT/DELETE thừa trên bảng này mỗi lần thêm hay xoá phần tử! Lúc này cùng một quan hệ được lưu hai nơi: cột FK department_id trong bảng employee và bảng junction, hai bên rất dễ lệch nhau.
Nếu thật sự chỉ cần quan hệ một chiều từ Department, có thể thêm @JoinColumn(name = "department_id") lên @OneToMany để bỏ bảng junction. Có điều Hibernate vẫn phải chạy thêm câu UPDATE để gán FK sau khi insert, nên với quan hệ cha-con thông thường thì hai chiều có mappedBy vẫn gọn nhất.
# eager ngầm và n+1 query
# FetchType.EAGER mặc định của @ManyToOne
Theo đặc tả JPA:
@OneToManymặc định làFetchType.LAZY(an toàn).@ManyToOneMẶC ĐỊNH LÀFetchType.EAGER(rất nguy hiểm!).
Query 100 Employee bằng JPQL hay findAll() là Hibernate tự bắn thêm query lẻ để load Department của từng người, ngay cả khi bạn không đụng tới department. Department nào đã nằm trong persistence context thì không query lại, nên số query thêm bằng số department khác nhau, tệ nhất là 100. EAGER còn có cái dở là không tắt được theo từng query: chỗ nào cần department thì JOIN FETCH được, chứ LAZY thì không "ép" ngược lại được.
WARNING
Quy tắc bắt buộc: Mọi @ManyToOne trong codebase LUÔN PHẢI khai báo rõ: @ManyToOne(fetch = FetchType.LAZY)!
# n+1 query trên @OneToMany
Khi bạn duyệt danh sách phòng ban rồi đụng vào danh sách nhân viên:
List<Department> depts = departmentRepository.findAll(); // 1 câu query lấy N departments
for (Department dept : depts) {
    System.out.println(dept.getEmployees().size()); // Phát sinh N câu query con!
}
Tổng số query xuống DB là 1 + N. Mỗi query riêng lẻ thì nhanh, nhưng với N = 1,000 là 1,001 lượt đi về qua mạng, cộng thêm việc chiếm connection lâu, nên API chậm hẳn và database cũng phải gánh gấp N lần số câu query cho mỗi request.
# cách xử lý n+1
Tuỳ tình huống, bạn có 3 lựa chọn:
# cách 1: JOIN FETCH trong jpql
Bắt Hibernate dùng INNER JOIN hoặc LEFT JOIN để load cả parent lẫn children trong một câu query:
public interface DepartmentRepository extends JpaRepository<Department, Long> {

    @Query("SELECT DISTINCT d FROM Department d LEFT JOIN FETCH d.employees")
    List<Department> findAllWithEmployees();
}
Từ Hibernate 6, kết quả có fetch join collection được tự động bỏ trùng, nên DISTINCT ở đây không còn bắt buộc (Hibernate 5 thì cần, không có sẽ nhận về mỗi department lặp lại theo số employee).
# cách 2: @EntityGraph cho linh hoạt
Vẫn dùng được các method có sẵn của Spring Data JPA (findAll, findById) mà vẫn load LAZY collection theo ý mình:
public interface DepartmentRepository extends JpaRepository<Department, Long> {

    @EntityGraph(attributePaths = {"employees"})
    List<Department> findAll();
}
Bên dưới @EntityGraph cũng sinh LEFT JOIN y như JOIN FETCH, nên nó dính đúng mấy cái bẫy của JOIN FETCH ở phần dưới (phân trang, nhiều collection).
# cách 3: @BatchSize khi phân trang
Khi cần phân trang (Pagination) danh sách parent (Pageable), dùng JOIN FETCH sẽ bị Hibernate cảnh báo: HHH90003004: firstResult/maxResults specified with collection fetch; applying in memory (Hibernate 5 ghi mã HHH000104). Vì mỗi department bị lặp thành nhiều dòng, LIMIT không cắt đúng theo department được, nên Hibernate bỏ LIMIT khỏi SQL, kéo hết dữ liệu lên RAM rồi tự phân trang, dễ OOM.
Trường hợp này thì dùng @BatchSize:
@Entity
public class Department {
    // ...
    @OneToMany(mappedBy = "department")
    @BatchSize(size = 50) // Khi duyệt collection, Hibernate gom 50 parent IDs thành 1 câu: WHERE department_id IN (?, ?, ...)
    private Set<Employee> employees = new HashSet<>();
}
Số query giảm từ 1 + N xuống còn 1 + ceil(N / 50)!
Không muốn gắn annotation cho từng collection thì đặt một lần cho cả app bằng spring.jpa.properties.hibernate.default_batch_fetch_size=50.
TIP
Chọn cách nào:
- Không phân trang và cần dữ liệu con ngay: dùng
@EntityGraphhoặcJOIN FETCH. - Có phân trang (
Pageable): đừng dùngJOIN FETCH, dùng@BatchSize(size = 50).
# bẫy cartesian product và MultipleBagFetchException
Lỗi rất hay gặp khi cố fetch cùng lúc nhiều hơn một quan hệ 1-N:
// Giả sử Department có cả: List<Employee> employees VÀ List<Project> projects
@Query("SELECT d FROM Department d LEFT JOIN FETCH d.employees LEFT JOIN FETCH d.projects")
List<Department> findBadQuery(); // 🔴 CRASH: MultipleBagFetchException
# nguyên nhân
Một department có 100 employees và 20 projects thì tích Descartes (Cartesian Product) trên DB sẽ trả về:
100 * 20 = 2,000 dòng kết quả lặp đi lặp lại!Trong Java, java.util.List không có @OrderColumn được Hibernate quản lý dưới dạng "bag" (PersistentBag), loại collection cho phép phần tử trùng. Hibernate từ chối chạy vì nhìn vào 2,000 dòng lặp đi lặp lại kia, nó không phân biệt được đâu là trùng do JOIN, đâu là phần tử trùng thật trong List, nên không biết map vào hai List riêng thế nào cho đúng số lượng.
# cách xử lý
- Đổi
ListsangSet: dùngSet<Employee>vàSet<Project>. Hibernate dùng hash để tự bỏ các bản ghi trùng do Cartesian Product sinh ra, nên hết exception. Nhưng cẩn thận: DB vẫn trả về đủ 2,000 dòng, chỉ là Hibernate lọc trùng ở phía Java. Exception biến mất, còn cái giá của Cartesian Product thì vẫn còn nguyên, vì số dòng bằng tích kích thước các collection. - Tách thành hai query riêng: fetch
employeesở query 1, rồi fetchprojectsở query 2 (ví dụ... LEFT JOIN FETCH d.projects WHERE d IN :depts), trong cùng một@Transactional. Persistence Context (first-level cache) của Hibernate sẽ tự nối các entity lại với nhau trong bộ nhớ, không sinh tích Descartes. Với collection lớn thì đây mới là cách nên chọn.
# đồng bộ trạng thái hai chiều
Một lỗi logic khá tai hại là gán quan hệ ở một phía mà quên cập nhật phía còn lại trong bộ nhớ:
Department dept = departmentRepository.findById(1L).get();
Employee emp = new Employee();
emp.setDepartment(dept); // Chỉ set owning side!

// Lúc này, trong Hibernate First-Level Cache:
dept.getEmployees().contains(emp); // 🔴 TRẢ VỀ FALSE! Dữ liệu trong RAM bị lệch pha!
# viết helper method cho đúng
@Entity
public class Department {
    @Id @GeneratedValue(strategy = GenerationType.IDENTITY)
    private Long id;

    private String name;

    @OneToMany(mappedBy = "department", cascade = CascadeType.ALL, orphanRemoval = true)
    private Set<Employee> employees = new HashSet<>();

    // Helper methods đảm bảo tính nhất quán 100% cho bộ nhớ RAM
    public void addEmployee(Employee employee) {
        employees.add(employee);
        employee.setDepartment(this);
    }

    public void removeEmployee(Employee employee) {
        employees.remove(employee);
        employee.setDepartment(null);
    }
}
NOTE
Với orphanRemoval = true, khi một Employee bị gỡ khỏi danh sách bằng department.getEmployees().remove(emp), Hibernate sẽ tự sinh lệnh DELETE FROM employees WHERE id = ? xuống database.
# lombok anti-pattern và StackOverflowError
Nhiều người dùng Lombok quen tay đặt @Data lên JPA Entity:
@Entity
@Data // 🔴 TỬ HUYỆT CỦA JPA ENTITY!
public class Department {
    @OneToMany(mappedBy = "department")
    private Set<Employee> employees;
}

@Entity
@Data // 🔴 TỬ HUYỆT!
public class Employee {
    @ManyToOne(fetch = FetchType.LAZY)
    private Department department;
}
# vì sao không được dùng @Data cho jpa entity
- Đệ quy vô tận trong
toString():Department.toString()gọiEmployee.toString(), rồiEmployee.toString()lại gọi ngượcDepartment.toString(). Kết quả:StackOverflowError, thread chết ngay.hashCode()cũng vòng y như vậy:Department.hashCode()tính trênemployees, mỗiEmployee.hashCode()lại tính trêndepartment, nên chỉ cần thêm employee vàoSetlà có thể nổ. Thêm nữa,toString()đụng vào quan hệ LAZY sẽ kích hoạt query ngầm, hoặc némLazyInitializationExceptionnếu session đã đóng (ví dụ lúc log entity). equals()vàhashCode()thay đổi giữa chừng:@DatasinhequalsvàhashCodedựa trên tất cả các field (kể cả ID). Entity mới tạo (new Employee()) cóidlànull. Saurepository.save(), DB sinhidmới (ví dụ1L).hashCodeđổi sau khi persist sẽ làm hỏngHashSet/HashMap: entity vẫn nằm trong Set nhưng bạn tìm không ra!
# cấu hình jpa entity cho đúng
@Entity
@Getter
@Setter
@NoArgsConstructor
@AllArgsConstructor
public class Employee {

    @Id
    @GeneratedValue(strategy = GenerationType.IDENTITY)
    private Long id;

    private String fullName;

    @ManyToOne(fetch = FetchType.LAZY)
    @JoinColumn(name = "department_id")
    private Department department;

    // Chỉ dùng Khóa Nghiệp Vụ (Business Key) hoặc ID cố định cho equals/hashCode
    @Override
    public boolean equals(Object o) {
        if (this == o) return true;
        if (!(o instanceof Employee other)) return false;
        return id != null && id.equals(other.getId());
    }

    @Override
    public int hashCode() {
        return getClass().hashCode(); // Giá trị băm cố định bảo vệ tính nhất quán trong Set
    }
}
Mẹo hashCode() trả về hằng số nghe hơi lạ, nhưng nó giải quyết đúng vấn đề ở trên: entity trước và sau khi persist vẫn có cùng hash, nên không bị "lạc" trong HashSet. Đổi lại, mọi Employee rơi vào cùng một bucket, nên đừng nhét hàng chục nghìn entity vào một HashSet. Còn equals() chỉ coi hai entity là một khi cả hai đã có id trùng nhau, hai entity mới tạo (id null) luôn khác nhau.
# tổng kết và checklist
| Hạng mục | Quy tắc | Không theo thì sao |
|---|---|---|
| FetchType | Mọi @ManyToOne PHẢI khai báo fetch = FetchType.LAZY. | N+1 query âm thầm làm database đứng hình. |
| Mapping | Phía @OneToMany phải có mappedBy. | Sinh thêm bảng junction trung gian không cần thiết. |
| Data Structure | Ưu tiên Set<T>; không fetch nhiều collection trong một query. | MultipleBagFetchException, hoặc Cartesian Product nổ RAM. |
| Pagination | Phân trang thì đừng dùng JOIN FETCH, dùng @BatchSize. | Hibernate kéo cả bảng lên RAM rồi tự phân trang. |
| Lombok | Không dùng @Data trên JPA Entity, dùng riêng @Getter, @Setter. | StackOverflowError và lỗi hash code trong Set. |
| Encapsulation | Luôn viết method đồng bộ hai chiều (addXxx, removeXxx). | Dữ liệu trong RAM không khớp với DB. |
Chỉ là những ghi chép cá nhân với hy vọng mang lại chút giá trị. Nếu thấy hữu ích, đừng ngại chia sẻ cho bạn bè & đồng nghiệp nhé!
Happy coding 😎 👍🏻 🚀 🔥.