microservice communicate pattern
Tung Bui Thanh (TungDaDev)15 mins read
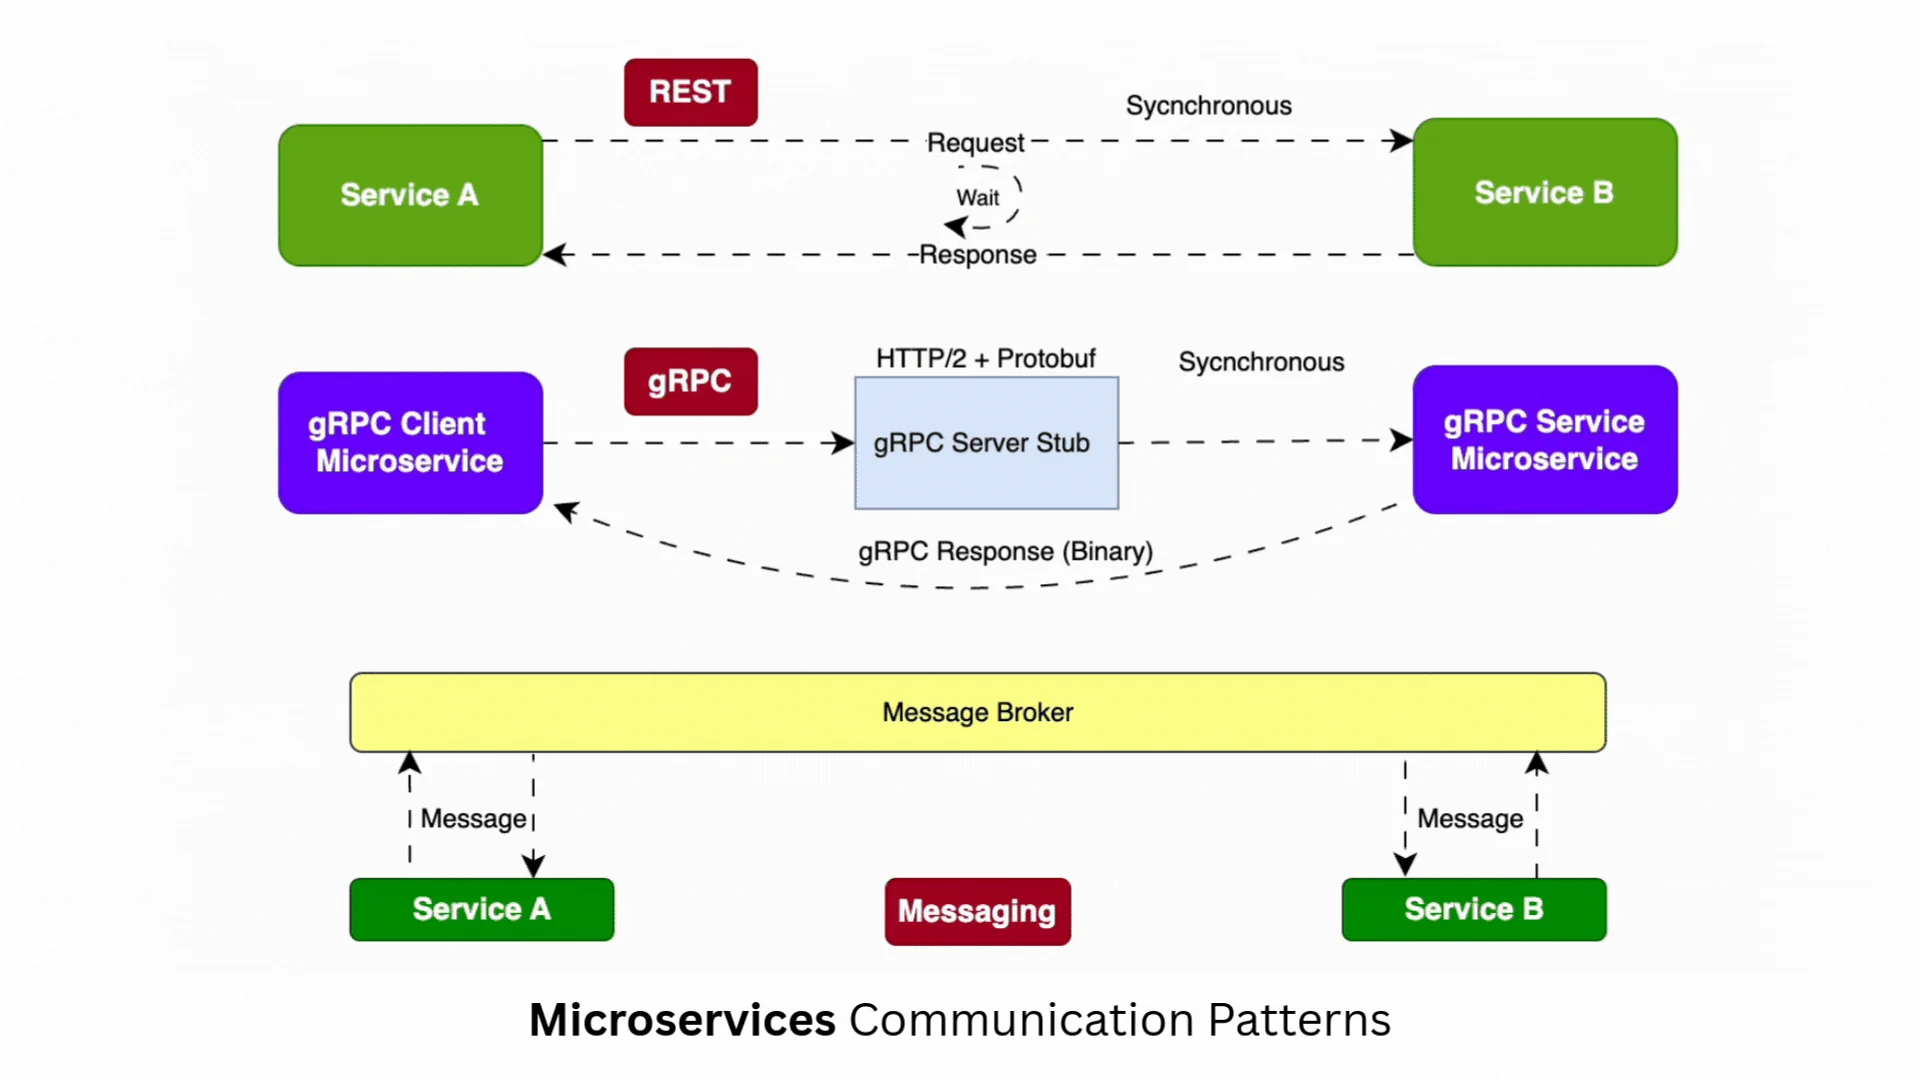
Tách một khối monolithic lớn thành microservices thì được tự do hơn, nhưng độ phức tạp cũng tăng theo. Trong hệ phân tán, mạng không bao giờ đáng tin. Node có thể chết bất cứ lúc nào, độ trễ âm thầm cộng dồn, và gỡ lỗi nhiều khi như mò kim đáy bể.
Hệ thống chạy ổn thường không nhờ công nghệ hào nhoáng, mà nhờ dữ liệu đi giữa các service gọn gàng. Bỏ bớt những lời gọi lắt nhắt (chatty communication), chỉ giữ những cuộc gọi thật sự cần.
Dưới đây là các pattern giao tiếp giữa microservices, cách bảo vệ hệ thống khi có sự cố và cách lần ra lỗi khi request chạy qua cả chục service.
# synchronous communication
Giao tiếp đồng bộ là phía gọi (client) phải chờ phía nhận (server) trả lời. Được cái luồng logic rõ ràng, dễ theo dõi, nhưng đổi lại hai bên phụ thuộc chặt về thời gian (temporal coupling).
# rest (WebClient / RestClient)
Từ Spring 6.1 (Spring Boot 3.2), RestClient là client HTTP kiểu blocking với API fluent, thay cho RestTemplate ở code mới. Nó hợp với phần lớn luồng nghiệp vụ, nhất là khi bật virtual threads. WebClient thì dành cho ứng dụng reactive (WebFlux), nơi cả chuỗi xử lý là non-blocking.
// Lựa chọn 1: Spring 6 RestClient (Blocking, thiết kế thanh lịch)
@Component
public class UserClient {
   private final RestClient restClient;

   public UserClient(@Value("${service.user.url}") String baseUrl) {
       this.restClient = RestClient.builder()
           .baseUrl(baseUrl)
           .defaultHeader("Content-Type", "application/json")
           .build();
   }

   public UserDTO getUser(UUID id, String token) {
       return restClient.get()
           .uri("/users/{id}", id)
           .header("Authorization", "Bearer " + token)
           .retrieve()
           // Chỉ 404 mới là "không tìm thấy"; 401/403/400 không nên bị gộp vào đây
           .onStatus(status -> status.value() == 404, (req, res) -> {
               throw new UserNotFoundException(id);
           })
           .body(UserDTO.class);
   }
}

// Lựa chọn 2: WebClient (Non-blocking, hướng tới hiệu năng cao)
@Component
public class AsyncUserClient {
   private final WebClient webClient;

   public AsyncUserClient(WebClient.Builder builder, @Value("${service.user.url}") String baseUrl) {
       this.webClient = builder.baseUrl(baseUrl).build();
   }

   public Mono<UserDTO> getUser(UUID id) {
       return webClient.get()
           .uri("/users/{id}", id)
           .retrieve()
           .bodyToMono(UserDTO.class)
           .timeout(Duration.ofSeconds(3))
           .onErrorResume(WebClientResponseException.NotFound.class,
               e -> Mono.empty());
   }
}
# gRPC
Khi cần giao tiếp nội bộ (service-to-service) với độ trễ thấp và payload nhỏ, gRPC là lựa chọn rất hợp. Nó chạy trên HTTP/2 (nhiều request đi chung một connection) và mã hoá bằng Protobuf, gọn và parse nhanh hơn JSON. Đổi lại, hai bên phải chia sẻ file .proto, và debug bằng mắt khó hơn. Chú ý deadline: withDeadlineAfter tính từ lúc gọi hàm, nên phải gọi lại cho từng request như ví dụ dưới, đừng tạo stub có deadline một lần rồi dùng mãi.
// High-performance binary protocol
// Proto definition → generated stubs
@GrpcService
public class UserGrpcService extends UserServiceGrpc.UserServiceImplBase {
   @Override
   public void getUser(GetUserRequest request, StreamObserver<UserResponse> observer) {
       User user = userService.findById(request.getId());
       observer.onNext(toProto(user));
       observer.onCompleted();
   }
}

// Client
@Component
public class UserGrpcClient {
   private final UserServiceGrpc.UserServiceBlockingStub stub;

   public UserResponse getUser(String id) {
       return stub.withDeadlineAfter(3, TimeUnit.SECONDS)
           .getUser(GetUserRequest.newBuilder().setId(id).build());
   }
}
# khi nào dùng
| Protocol | Use Case | Trade-off |
|---|---|---|
| REST | CRUD, public APIs, simple queries | Human-readable, higher latency |
| gRPC | Internal service-to-service, streaming | Fast, binary, requires proto contract |
| GraphQL | Frontend aggregation, flexible queries | Complexity, N+1 risk |
# asynchronous communication
Giống như gửi thư rồi đi làm việc khác, không đứng chờ người đưa thư mang hồi âm về. Kiến trúc Event-Driven làm các service bớt phụ thuộc vào nhau. Lúc này các service chỉ giao tiếp qua Domain Events, giữ đúng tinh thần Clean Architecture: lớp Application/Domain không biết các service khác tồn tại.
# event-driven (rabbitmq/kafka)
Pattern "fire-and-forget": service gửi event rồi trả lời luôn, phần việc phụ (trừ kho, gửi email) do service khác làm sau. Request của user nhanh hơn, và service phía sau có chết vài phút thì message vẫn nằm chờ trong queue.
@Service
public class OrderService {
   public Order createOrder(CreateOrderDTO dto) {
       // 1. Lưu trạng thái vào core domain
       Order order = repo.save(map(dto));

       // 2. Bắn sự kiện ra thế giới bên ngoài (Infrastructure layer)
       // OrderService không cần biết ai sẽ xử lý (Inventory, Notification, etc.)
       rabbitTemplate.convertAndSend(
           "order.exchange",
           "order.created",
           new OrderCreatedEvent(order.getId())
       );

       return order;
   }
}
Ví dụ này có lỗ hổng kinh điển "dual write": lưu DB và gửi message là hai hệ thống riêng. DB lưu xong mà broker lỗi (hoặc app chết ngay giữa hai bước) thì event mất; còn nếu gửi trong một transaction rồi transaction rollback thì event lại đi ra cho một đơn hàng không tồn tại. Cần chắc chắn thì dùng Transactional Outbox: ghi event vào bảng outbox cùng transaction với order, rồi một tiến trình khác (polling hoặc CDC như Debezium) đẩy lên broker. Bên nhận vẫn phải idempotent vì message có thể tới hơn một lần.
# request-reply (async rpc)
Có lúc bạn vẫn cần câu trả lời, nhưng muốn đi qua broker: bên xử lý có thể scale, restart mà bên gọi không cần biết địa chỉ của nó. Request-Reply trên RabbitMQ làm được chuyện này. Lưu ý sendAndReceive vẫn chặn thread cho tới khi có reply hoặc hết replyTimeout (mặc định 5 giây), hết giờ thì trả về null. Muốn không chặn thread thì dùng AsyncRabbitTemplate, nó trả về future.
public PaymentResult requestPayment(PaymentRequest request) {
   Message reply = rabbitTemplate.sendAndReceive(
       "payment.exchange",
       "payment.process",
       MessageBuilder.withBody(serialize(request))
           .setCorrelationId(UUID.randomUUID().toString())
           .build()
   );
   if (reply == null) { // hết replyTimeout mà chưa có phản hồi
       throw new PaymentTimeoutException(request);
   }
   return deserialize(reply.getBody(), PaymentResult.class);
}
# resilience patterns
Lời gọi ra bên ngoài nào cũng có rủi ro. Không có cơ chế phòng ngự thì một service "chết" sẽ kéo cả hệ thống sập theo kiểu dây chuyền (cascading failure). Trong Spring, Resilience4j là lựa chọn phổ biến hiện nay.
# circuit breaker (Resilience4j)
Khi một service hạ nguồn bắt đầu lỗi liên tục, thay vì cứ gọi tiếp, Circuit Breaker ngắt mạch (Open) và trả về Fallback ngay để giữ tài nguyên.
// Dependency
// implementation 'io.github.resilience4j:resilience4j-spring-boot3'

@Service
public class PaymentClient {

   @CircuitBreaker(name = "paymentService", fallbackMethod = "paymentFallback")
   public PaymentResult processPayment(PaymentRequest request) {
       return restClient.post()
           .uri("/payments")
           .body(request)
           .retrieve()
           .body(PaymentResult.class);
   }

   // Lưới an toàn: hứng lỗi khi cầu dao mở hoặc mạng đứt
   private PaymentResult paymentFallback(PaymentRequest request, Throwable t) {
       log.warn("Payment service gián đoạn. Chuyển vào hàng đợi: {}", t.getMessage());
       rabbitTemplate.convertAndSend("payment.retry.queue", request);
       return PaymentResult.pending("Đang chờ xử lý");
   }
}
Configuration:
resilience4j:
  circuitbreaker:
    instances:
      paymentService:
        sliding-window-size: 10
        failure-rate-threshold: 50 # open after 50% failures
        wait-duration-in-open-state: 30s # wait before half-open
        permitted-number-of-calls-in-half-open-state: 3
        slow-call-duration-threshold: 2s
        slow-call-rate-threshold: 80
Hai điểm nên để ý. Fallback ở trên hứng mọi exception, kể cả lỗi nghiệp vụ như request sai dữ liệu (400): những lỗi đó nên được bỏ qua qua ignore-exceptions, không thì bị đẩy vào hàng đợi retry vô ích. Và vì payment có thể được xử lý lại từ queue, phía payment phải chống trùng bằng idempotency key.
# retry
Thử lại những lỗi thoáng qua (transient errors) như rớt mạng tức thời. Lưu ý: nên đi kèm exponential backoff (thời gian chờ tăng dần, tốt nhất có thêm chút ngẫu nhiên để các client không retry cùng lúc) và thao tác gọi phải idempotent (gọi nhiều lần không đổi kết quả).
@Retry(name = "externalApi", fallbackMethod = "retryFallback")
public DataDTO fetchData(String id) {
   return restClient.get().uri("/data/{id}", id).retrieve().body(DataDTO.class);
}resilience4j:
retry:
instances:
externalApi:
max-attempts: 3
wait-duration: 1s
enable-exponential-backoff: true # thiếu dòng này thì multiplier bị bỏ qua
exponential-backoff-multiplier: 2
retry-exceptions:
# RestClient bọc IOException trong ResourceAccessException,
# mà Resilience4j chỉ so kiểu của chính exception, không xét cause
- org.springframework.web.client.ResourceAccessException
- org.springframework.web.client.HttpServerErrorException
ignore-exceptions:
- com.example.BusinessException# rate limiter
Giới hạn tốc độ gọi API để không làm quá tải đối tác thứ 3. Rate limiter của Resilience4j đếm trong bộ nhớ của từng instance: chạy 5 pod thì tổng thực tế là 5 x 100 request/giây. Cần giới hạn chung cho cả cụm thì phải đếm ở chỗ dùng chung (Redis, API gateway).
@RateLimiter(name = "thirdPartyApi")
public Response callThirdParty(Request request) {
   return externalClient.call(request);
}resilience4j:
ratelimiter:
instances:
thirdPartyApi:
limit-for-period: 100
limit-refresh-period: 1s
timeout-duration: 500ms# bulkhead (isolation)
Cô lập tài nguyên: giới hạn thread pool cho một chức năng nặng để nó không "ăn" hết tài nguyên của cả ứng dụng.
// THREADPOOL bulkhead chỉ áp được cho method trả về CompletionStage/CompletableFuture
@Bulkhead(name = "heavyOperation", type = Bulkhead.Type.THREADPOOL)
public CompletableFuture<Result> processHeavy(Request request) {
   return CompletableFuture.completedFuture(heavyService.process(request));
}resilience4j:
bulkhead: # cấu hình cho type SEMAPHORE (mặc định)
instances:
heavyOperation:
max-concurrent-calls: 10
max-wait-duration: 500ms
thread-pool-bulkhead: # cấu hình cho type THREADPOOL như ví dụ trên
instances:
heavyOperation:
max-thread-pool-size: 5
core-thread-pool-size: 3
queue-capacity: 20# combining patterns
Khi gắn nhiều annotation lên một method, Resilience4j bọc theo thứ tự mặc định từ ngoài vào trong: Retry → CircuitBreaker → RateLimiter → TimeLimiter → Bulkhead. Thứ tự viết annotation trong code không ảnh hưởng; muốn đổi thì chỉnh các property *-aspect-order (vd resilience4j.retry.retry-aspect-order). Hệ quả: mỗi lần Retry thử lại đều được CircuitBreaker ghi nhận, và khi circuit đã OPEN thì Retry sẽ nhận CallNotPermittedException, nên thêm exception này vào ignore-exceptions của retry để khỏi thử lại vô ích.
// Thứ tự annotation trong code không quan trọng; mặc định Retry bọc ngoài CircuitBreaker, rồi tới RateLimiter
@CircuitBreaker(name = "backend")
@Retry(name = "backend")
@RateLimiter(name = "backend")
public Response callBackend(Request request) {
   return client.call(request);
}
# timeout chains
Quản lý thời gian chờ trong microservices dễ bị bỏ sót. Giả sử Client gọi A, A gọi B, B gọi C, và mỗi chặng đều đặt timeout 5s. C treo: tới giây thứ 5 thì A bỏ cuộc và trả lỗi cho client, nhưng B vẫn đang chờ C, có khi còn retry C thêm vài lần. Toàn bộ phần việc đó là công cốc, vẫn chiếm thread và connection. Thêm retry ở nhiều tầng thì còn tệ hơn: A retry 3 lần, mỗi lần B lại retry C 3 lần là C ăn 9 request cho một yêu cầu của user. Nguyên tắc: timeout của tầng trong phải nhỏ hơn tầng ngoài, và tốt nhất truyền "hạn chót" (deadline) xuống dưới để mỗi service biết mình còn bao nhiêu thời gian. gRPC làm sẵn chuyện này: deadline được truyền qua header grpc-timeout.
# Solution: Cascading timeouts
# Service A (gateway) — total budget: 5s
service-b:
  timeout: 3s # leaves 2s for own processing

# Service B — budget from A: 3s
service-c:
timeout: 1.5s # leaves 1.5s for own processing@GetMapping("/aggregate")
public AggregateDTO aggregate(@RequestHeader("X-Request-Deadline") Optional<Instant> deadline) {
// Nếu không có, gán ngân sách tổng là 5 giây
Instant myDeadline = deadline.orElse(Instant.now().plusSeconds(5));
Duration remaining = Duration.between(Instant.now(), myDeadline);
if (remaining.isNegative() || remaining.isZero()) {
// TimeoutException của JDK là checked exception, không throw thẳng được ở đây
throw new ResponseStatusException(HttpStatus.GATEWAY_TIMEOUT, "Ngân sách thời gian đã cạn, huỷ xử lý.");
}
// Chỉ cấp cho các lời gọi hạ nguồn phần thời gian còn lại,
// và truyền tiếp deadline mới qua header X-Request-Deadline cho service sau
Duration downstreamBudget = remaining.dividedBy(2);
return client.getData(downstreamBudget);
}Truyền deadline dạng thời điểm tuyệt đối thì phụ thuộc đồng hồ các máy phải khớp nhau (NTP). Lệch vài trăm ms là budget sai theo; truyền dạng "còn lại bao nhiêu ms" như gRPC thì tránh được chuyện này, đổi lại phải trừ thời gian đi đường.
# service discovery
Trong cụm hàng chục services có IP liên tục đổi (do scale up/down), không nên hardcode URL. Service Discovery (như Eureka) giúp các service tự tìm nhau qua tên service. Nếu chạy trên Kubernetes thì thường không cần Eureka: Service của Kubernetes đã cho bạn một DNS name ổn định (vd http://user-service) và tự cân bằng tải.
# eureka (client-side discovery)
# Service registers itself
eureka:
  client:
    service-url:
      defaultZone: http://localhost:8087/eureka/
  instance:
    prefer-ip-address: true
    instance-id: ${spring.application.name}:${server.port}
// Load-balanced RestTemplate via service name (RestClient.Builder cũng gắn @LoadBalanced được)
@Bean
@LoadBalanced
public RestTemplate restTemplate() {
return new RestTemplate();
}
// Call by service name (Eureka resolves to IP:port)
restTemplate.getForObject("http://user-service/users/{id}", UserDTO.class, id);# fallback discovery (mongodb-based)
// When Eureka is unavailable — query MongoDB for registered services
public String resolveServiceUrl(String serviceName) {
   try {
       return eurekaClient.getNextServerFromEureka(serviceName, false).getHomePageUrl();
   } catch (Exception e) {
       // Fallback to MongoDB registry
       ServiceRegistration reg = mongoTemplate.findOne(
           Query.query(Criteria.where("serviceName").is(serviceName).and("status").is("UP")),
           ServiceRegistration.class);
       return reg != null ? reg.getUrl() : null;
   }
}
Trước khi dựng fallback kiểu này thì nên biết Eureka client vốn đã cache registry trong bộ nhớ và làm mới định kỳ (mặc định 30 giây). Eureka server chết một lúc thì các service vẫn gọi nhau được bằng bản cache. Một registry thứ hai trong MongoDB lại phải tự giữ cho trạng thái UP đúng thực tế, không thì fallback trả về địa chỉ của instance đã chết.
# distributed tracing
Để theo dõi được luồng xử lý, cần Distributed Tracing (OpenTelemetry + Micrometer). Trace ID được truyền qua mọi lời gọi HTTP và Message Broker, nên khi có sự cố ta dựng lại được toàn bộ đường đi của request.
# opentelemetry + micrometer
management:
  tracing:
    sampling:
      probability: 1.0 # 100% in dev, lower in prod (Spring Boot defaults to 0.1)
  otlp:
    tracing:
      endpoint: http://localhost:4318/v1/traces
// Auto-propagated via Micrometer Tracing
// HTTP headers: traceparent, tracestate (W3C format)
// RabbitMQ: message headers, nhưng phải bật observation cho RabbitTemplate/listener
// (spring.rabbitmq.template.observation-enabled=true, spring.rabbitmq.listener.simple.observation-enabled=true)
// Manual span creation
@Component
@RequiredArgsConstructor
public class CustomTracing {
private final Tracer tracer;
public void tracedOperation() {
Span span = tracer.nextSpan().name("custom-operation").start();
try (Tracer.SpanInScope ws = tracer.withSpan(span)) {
doWork();
span.tag("result", "success");
} catch (Exception e) {
span.error(e);
throw e;
} finally {
span.end();
}
}
}# api gateway patterns
# request routing
Thay vì để Frontend/Mobile phải gọi 5-7 services khác nhau (tạo ra "chatty communication"), nên đặt một cổng vào duy nhất.
Pattern BFF (Backend for Frontend) để Gateway hoặc một service riêng đứng ra tổng hợp dữ liệu, gọi song song các service phía sau rồi gộp kết quả. Ví dụ YAML dưới dùng cú pháp cũ spring.cloud.gateway.routes; từ Spring Cloud Gateway 4.3 (Spring Cloud 2025.0) prefix mới là spring.cloud.gateway.server.webflux.routes (bản WebFlux), cú pháp cũ đã deprecated.
# Spring Cloud Gateway (or custom proxy)
spring:
  cloud:
    gateway:
      routes:
        - id: user-service
          uri: lb://user-service
          predicates:
            - Path=/api/users/**
          filters:
            - StripPrefix=1
            - AddRequestHeader=X-Internal, true
# backend for frontend (bff)
@GetMapping("/dashboard")
public DashboardDTO getDashboard(@AuthenticationPrincipal JwtPayload user) {
   CompletableFuture<UserProfile> profile = CompletableFuture.supplyAsync(
       () -> userClient.getProfile(user.getSub()), executor);

   CompletableFuture<List<Order>> orders = CompletableFuture.supplyAsync(
       () -> orderClient.getRecent(user.getSub(), 5), executor);

   CompletableFuture<Notifications> notifications = CompletableFuture.supplyAsync(
       () -> notifClient.getUnread(user.getSub()), executor);

   // Chờ tất cả cùng hoàn thành
   CompletableFuture.allOf(profile, orders, notifications).join();

   return new DashboardDTO(profile.join(), orders.join(), notifications.join());
}
Code trên còn thiếu hai thứ khi chạy thật. Một là timeout: chỉ cần một service treo là join() treo theo; nên gắn .orTimeout(...) hoặc completeOnTimeout(giá trị mặc định, ...) cho từng future, nhất là phần không quan trọng như notifications. Hai là khi một future lỗi, join() ném CompletionException và cả dashboard lỗi theo; phần nào được phép thiếu thì nên exceptionally(...) trả giá trị rỗng. Ngoài ra, các thread của executor không tự có SecurityContext hay MDC/trace context của request; cần bọc executor (vd DelegatingSecurityContextExecutor, ContextExecutorService của Micrometer) nếu client phía dưới cần token hoặc trace ID.
# communication anti-patterns
| Anti-Pattern | Problem | Fix |
|---|---|---|
| Synchronous chain (A→B→C→D) | Latency compounds, single point of failure | Event-driven, async where possible |
| No timeout | Thread blocked forever | Always set timeout < caller's timeout |
| Chatty communication | N+1 calls, high latency | Batch API, BFF aggregation |
| Shared database | Tight coupling, schema conflicts | Each service owns its data |
| No circuit breaker | Cascading failure | Resilience4j circuit breaker |
| Hardcoded URLs | Fragile, no scaling | Service discovery (Eureka) |
| No retry on transient errors | Unnecessary failures | Retry with exponential backoff |
| Retry without idempotency | Duplicate side effects | Idempotency key in requests |
# decision matrix
| Requirement | Pattern |
|---|---|
| Need immediate response | Sync (REST/gRPC) + Circuit Breaker |
| Fire-and-forget | Async (RabbitMQ event) |
| Need guaranteed delivery | Outbox + Async messaging |
| High throughput, low latency | gRPC + connection pooling |
| Cross-service transaction | Saga (choreography or orchestration) |
| Aggregate for frontend | BFF + parallel async calls |
| External unreliable API | Circuit Breaker + Retry + Fallback |
Bắt đầu thì đơn giản thôi: mọi lời gọi ra ngoài đều có timeout, retry chỉ cho lỗi tạm thời và thao tác idempotent, event quan trọng thì đi qua outbox. Mấy pattern còn lại thêm vào khi số liệu tracing cho thấy cần.
Chỉ là những ghi chép cá nhân với hy vọng mang lại chút giá trị. Nếu thấy hữu ích, đừng ngại chia sẻ cho bạn bè & đồng nghiệp nhé!
Happy coding 😎 👍🏻 🚀 🔥.