map vs flatmap
Tung Bui Thanh (TungDaDev) (updated 6 months ago)12 mins read
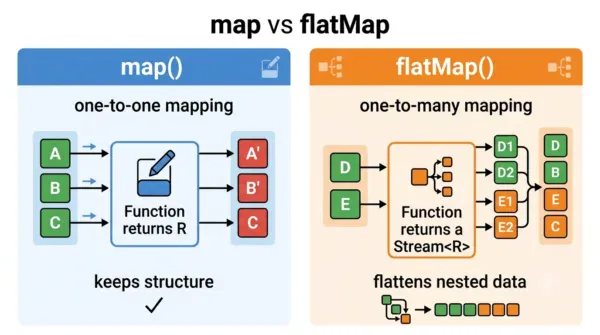
Từ khi Java 8 đưa phong cách hàm (Functional Programming) vào ngôn ngữ, map và flatMap trở thành hai toán tử biến đổi dữ liệu dùng nhiều nhất. Bạn gặp chúng ở khắp nơi: java.util.stream.Stream, java.util.Optional, CompletableFuture, hay Mono/Flux trong Spring WebFlux (Project Reactor).
Ai cũng thuộc câu cơ bản: "Dùng map khi biến đổi 1-1, dùng flatMap khi muốn làm phẳng (flatten) một tập hợp lồng nhau".
Nhưng nếu đào sâu hơn thì còn mấy câu hỏi:
- Bản chất toán học của
flatMaplà gì? Tại sao nó là phép toán chính của một Monad? - Tại sao lạm dụng
flatMaptrong Java Stream có thể làm Heap đầy rác và khiến Garbage Collector chạy liên tục (GC Churn)? mapMulticủa Java 16 giải quyết chuyện này ra sao?- Tại sao trong Reactive Streams, chọn nhầm giữa
flatMapvàconcatMapcó thể làm sai thứ tự giao dịch tài chính?
Mình sẽ đi lần lượt qua từng câu, từ lý thuyết tới chuyện chạy dưới tải cao.
# từ functor đến monadic bind
Theo Lý thuyết Phạm trù (Category Theory) và Lập trình Hàm:
- Một container bọc dữ liệu
M[T]là một Functor nếu nó hỗ trợ hàmmap:map: (T -> U) -> (M[T] -> M[U]) - Container đó là một Monad nếu nó còn hỗ trợ phép nối chuỗi (Monadic Bind, hay
flatMap):flatMap: (T -> M[U]) -> (M[T] -> M[U])
Nói cho đủ thì Monad còn cần một phép bọc giá trị vào container (unit, trong Java là Stream.of, Optional.of, CompletableFuture.completedFuture) và phải thoả vài luật (monad laws) để việc nối chuỗi cho kết quả nhất quán. Java không ép kiểu nào phải là Monad, đây chỉ là khuôn mẫu chung mà các API này cùng đi theo. Optional thậm chí không thoả trọn luật, vì map gặp hàm trả về null sẽ biến thành empty, nhưng để hiểu map/flatMap thì góc nhìn này vẫn rất có ích.
Nếu truyền một hàm trả về container (T -> M[U]) vào map, bạn sẽ nhận được cấu trúc lồng nhau: Stream<Stream<String>>, Optional<Optional<User>>, hoặc CompletableFuture<CompletableFuture<Order>>.
flatMap sinh ra để "bóc" lớp vỏ thừa đó.
# java stream: gc churn & mapMulti
Xem flatMap trong java.util.stream.Stream hoạt động thế nào:
// Ví dụ: Bóc tách danh sách đơn hàng
List<Order> orders = fetchLargeOrders(); // 1,000,000 đơn hàng

List<OrderItem> items = orders.stream()
    .flatMap(order -> order.getItems().stream()) // 🔴 NGUY CƠ HIỆU NĂNG!
    .toList();
# chuyện gì xảy ra trong heap?
Mỗi lần lambda order -> order.getItems().stream() được gọi:
getItems().stream()tạo một đối tượngStreammới. VớiArrayList, đó là một node pipelineReferencePipeline$Head.- Kèm theo nó là một
Spliteratorđể duyệt list. flatMapduyệt hết stream con, đẩy từng phần tử xuống phía sau, rồi đóng stream con. Hai đối tượng trên thành rác ngay sau đó.
Mình đo thử trên JDK 21 (đếm byte cấp phát của thread bằng ThreadMXBean): mỗi đơn hàng tốn khoảng 88 byte cho phần stream con này. Với 1 triệu đơn hàng là khoảng 2 triệu đối tượng, gần 90MB rác sinh ra chỉ để duyệt, chưa tính dữ liệu thật. Garbage Collector phải dọn liên tục (GC Allocation Churn).
Nói cho công bằng: đây là rác chết trẻ, mà young GC chỉ tốn công cho object còn sống, nên dọn loại rác này khá rẻ. Với phần lớn ứng dụng, flatMap vẫn ổn. Nó chỉ thành vấn đề ở hot-path chạy liên tục với khối lượng lớn, nơi tần suất young GC và băng thông bộ nhớ bắt đầu ảnh hưởng tới latency.
# stream mapMulti (java 16+)
Để tránh chuyện cấp phát này, Java 16 thêm method mapMulti:
<R> Stream<R> mapMulti(BiConsumer<? super T, ? super Consumer<R>> mapper)Thay vì bắt bạn trả về một Stream mới cho mỗi phần tử, mapMulti đưa cho bạn một Consumer, thật ra chính là bước kế tiếp của pipeline. Bạn tự viết vòng lặp kiểu imperative và đẩy thẳng từng phần tử con vào đó, không phải tạo stream con nào:
// Tối ưu hóa với mapMulti (Zero Stream Allocation):
List<OrderItem> optimizedItems = orders.stream()
    .<OrderItem>mapMulti((order, consumer) -> {
        for (OrderItem item : order.getItems()) {
            consumer.accept(item); // Đẩy thẳng xuống bước kế tiếp (downstream) của pipeline
        }
    })
    .toList();
TIP
Về hiệu năng: Cùng phép đo ở trên (1 triệu đơn, mỗi đơn 1-3 item, JDK 21): mapMulti gần như không cấp phát gì thêm (iterator của vòng for được escape analysis loại bỏ), còn flatMap tốn ~88 byte mỗi đơn. Thời gian chạy cũng nhanh hơn vài lần, nhưng đó chỉ là phép đo thô, chưa phải JMH. Khi xử lý từng phần tử nặng hơn hẳn việc duyệt thì chênh lệch sẽ nhỏ đi nhiều. Nhớ tự benchmark trên dữ liệu của bạn.
Javadoc của mapMulti cũng nói rõ khi nào nên dùng: mỗi phần tử sinh ra ít (có thể là 0) phần tử con, hoặc khi viết vòng lặp imperative dễ hơn là dựng một stream. Còn nếu bạn đã có sẵn một Stream con thì cứ dùng flatMap cho dễ đọc.
# optional: loại bỏ null-check hell
Kiểu lập trình hướng đối tượng truyền thống hay phải check null lồng nhau (Defensive Null-Checking), ra thứ code hình kim tự tháp (Pyramid of Doom):
// Code truyền thống: Dễ sót, khó đọc
if (user != null) {
    Address address = user.getAddress();
    if (address != null) {
        City city = address.getCity();
        if (city != null) {
            return city.getName().toUpperCase();
        }
    }
}
return "UNKNOWN";
# monadic chaining với optional flatMap
Giả sử domain entity dùng Optional cho các trường có thể không có giá trị:
public class User {
    public Optional<Address> getAddress() { return Optional.ofNullable(address); }
}
public class Address {
    public Optional<City> getCity() { return Optional.ofNullable(city); }
}
public class City {
    public String getName() { return name; }
}
Pipeline gọn, không có lệnh if nào và không lo NullPointerException:
String cityName = userRepository.findById(userId)
    .flatMap(User::getAddress)
    .flatMap(Address::getCity)
    .map(City::getName)
    .map(String::toUpperCase)
    .orElse("UNKNOWN");
# completableFuture: thenApply vs thenCompose
Trong lập trình bất đồng bộ (Non-blocking Asynchronous Programming), cặp này lặp lại y hệt:
thenApply(tương đươngmap): áp dụng một hàm đồng bộ lên kết quả của Future.thenCompose(tương đươngflatMap): nối tiếp một tác vụ bất đồng bộ khác (trả về mộtCompletableFuturekhác).
# ví dụ trong microservices orchestration
public CompletableFuture<UserProfileSummary> buildUserProfileAsync(String userId) {
    return userClient.fetchUserAsync(userId) // 1. Async: Lấy User (CF<User>)
        .thenCompose(user ->
            // 2. Async: Lấy Order dựa vào User ID vừa lấy được (CF<List<Order>>)
            orderClient.fetchOrdersAsync(user.getId())
                .thenApply(orders -> new UserProfileSummary(user, orders)) // 3. Sync: Gom dữ liệu
        )
        .thenCompose(summary ->
            // 4. Async: Ghi audit (CF<Void>) rồi trả về summary ban đầu
            auditClient.recordAccessAsync(summary.user().getId())
                .thenApply(ignored -> summary)
        );
}
Hai chỗ cần để ý trong đoạn này. Thứ nhất, user phải có trước thì mới lấy được order, nên hai bước phải nối nhau bằng thenCompose. Nếu hai tác vụ độc lập thì đừng nối tuần tự như vậy, dùng thenCombine hoặc CompletableFuture.allOf để chúng chạy cùng lúc. Thứ hai, ghi audit lỗi thì cả buildUserProfileAsync lỗi theo. Nếu audit chỉ là phụ, nên chặn lỗi lại ngay ở bước đó, ví dụ .exceptionally(ex -> null) trước .thenApply(ignored -> summary).
# reactive streams: cạm bẫy flatMap vs concatMap
Đây là lỗi khá nghiêm trọng trong hệ thống xử lý giao dịch tài chính dùng Spring WebFlux:
# mất thứ tự giao dịch với flux flatMap
flatMap trong Project Reactor (hoặc RxJava) subscribe đồng thời nhiều luồng con (với Reactor mặc định tối đa concurrency = 256 inner publishers), không chờ luồng con trước xong mới chạy luồng sau.
- Kết quả từ các luồng con được merge xen kẽ (Interleaved) ngay khi sẵn sàng.
- Hậu quả: thứ tự ban đầu của các phần tử không còn được giữ.
# chọn toán tử nào
| Toán tử Reactive | Tính chất thứ tự (Ordering) | Mức độ song song (Concurrency) | Use Case chuẩn |
|---|---|---|---|
flatMap | 🔴 Không bảo toàn thứ tự | 🚀 Chạy song song tối đa (mặc định 256) | Lấy dữ liệu đọc (Read-only), gọi API độc lập, không cần thứ tự. |
concatMap | 🟢 Bảo toàn thứ tự 100% | 🐢 Tuần tự (Chờ inner stream trước hoàn thành mới chạy stream sau) | Xử lý giao dịch tài chính, sổ cái kế toán (Ledger), ghi log tuần tự. |
flatMapSequential | 🟢 Bảo toàn thứ tự 100% | ⚡ Chạy song song nhưng buffer lại kết quả để emit đúng thứ tự ban đầu | Khi cần chạy song song nhưng output phải theo đúng thứ tự input. |
// Ví dụ xử lý chuỗi giao dịch tài chính yêu cầu thứ tự nghiêm ngặt:
Flux<Transaction> transactions = getIncomingTransactionStream();

// KHÔNG DÙNG: transactions.flatMap(this::processPayment) // 🔴 LỖI THỨ TỰ!

// DÙNG: concatMap để đảm bảo Tx1 xong hoàn toàn mới đến Tx2
Flux<Receipt> receipts = transactions
    .concatMap(tx -> paymentProcessor.executeStrictOrder(tx));
Một điểm hay bị hiểu nhầm về flatMapSequential: nó chỉ sắp lại thứ tự output. Các tác vụ con vẫn chạy đồng thời, nên nếu processPayment ghi DB hay gọi API trừ tiền thì Tx2 vẫn có thể được thực thi trước Tx1. Với giao dịch có tác dụng phụ cần đúng thứ tự, chỉ concatMap mới an toàn.
Nhưng concatMap cho cả luồng thì chậm, vì mọi giao dịch phải xếp một hàng. Thực tế thường chỉ cần đúng thứ tự trong cùng một tài khoản. Khi đó có thể nhóm theo tài khoản: transactions.groupBy(Transaction::accountId).flatMap(group -> group.concatMap(this::processPayment), maxGroups). Các tài khoản khác nhau chạy đồng thời, còn trong mỗi tài khoản vẫn tuần tự. Cẩn thận: số nhóm đang mở cùng lúc phải không vượt quá concurrency của flatMap (tham số maxGroups ở trên), nếu không pipeline có thể treo vì groupBy không còn chỗ phát nhóm mới.
WARNING
Lưu ý khi dùng concatMap: concatMap giữ thứ tự tuyệt đối, nhưng nếu một tác vụ con bị treo (stalled/timeout) thì mọi giao dịch phía sau bị dồn lại (Head-of-Line Blocking). Nên gắn timeout() cho từng tác vụ con khi dùng concatMap.
# bảng tổng hợp
| Môi trường / Framework | Toán tử 1-1 (Functor Map) | Toán tử Monadic Flattening (Monad Bind) | Đặc tính kỹ thuật chính |
|---|---|---|---|
java.util.stream.Stream | map() | flatMap() (Hoặc mapMulti() từ Java 16+) | Pipeline lazy. Lưu ý GC Churn khi flatMap khối lượng lớn. |
java.util.Optional | map() | flatMap() | Null-safe pipeline, tự động ngắn mạch (short-circuit). |
CompletableFuture | thenApply() | thenCompose() | Async chaining; bản *Async mặc định chạy trên commonPool. |
Project Reactor (Flux) | map() | flatMap() / concatMap() | Reactive Streams. Cảnh giác lỗi xen kẽ mất thứ tự với flatMap. |
# kết luận
map và flatMap có chung một ý tưởng gốc, và nó lặp lại ở Stream, Optional, CompletableFuture lẫn Reactor. Thuộc được cái khuôn chung đó thì gặp API mới cũng đoán được ngay nên dùng hàm nào.
Mấy chỗ đáng nhớ khi dùng thật: mapMulti cho hot-path của Stream, thenCompose khi bước sau phụ thuộc bước trước, và concatMap (hoặc groupBy + concatMap) khi thứ tự xử lý quan trọng trong Reactor.
Chỉ là những ghi chép cá nhân với hy vọng mang lại chút giá trị. Nếu thấy hữu ích, đừng ngại chia sẻ cho bạn bè & đồng nghiệp nhé!
Happy coding 😎 👍🏻 🚀 🔥.