map in java
Tung Bui Thanh (TungDaDev)13 mins read
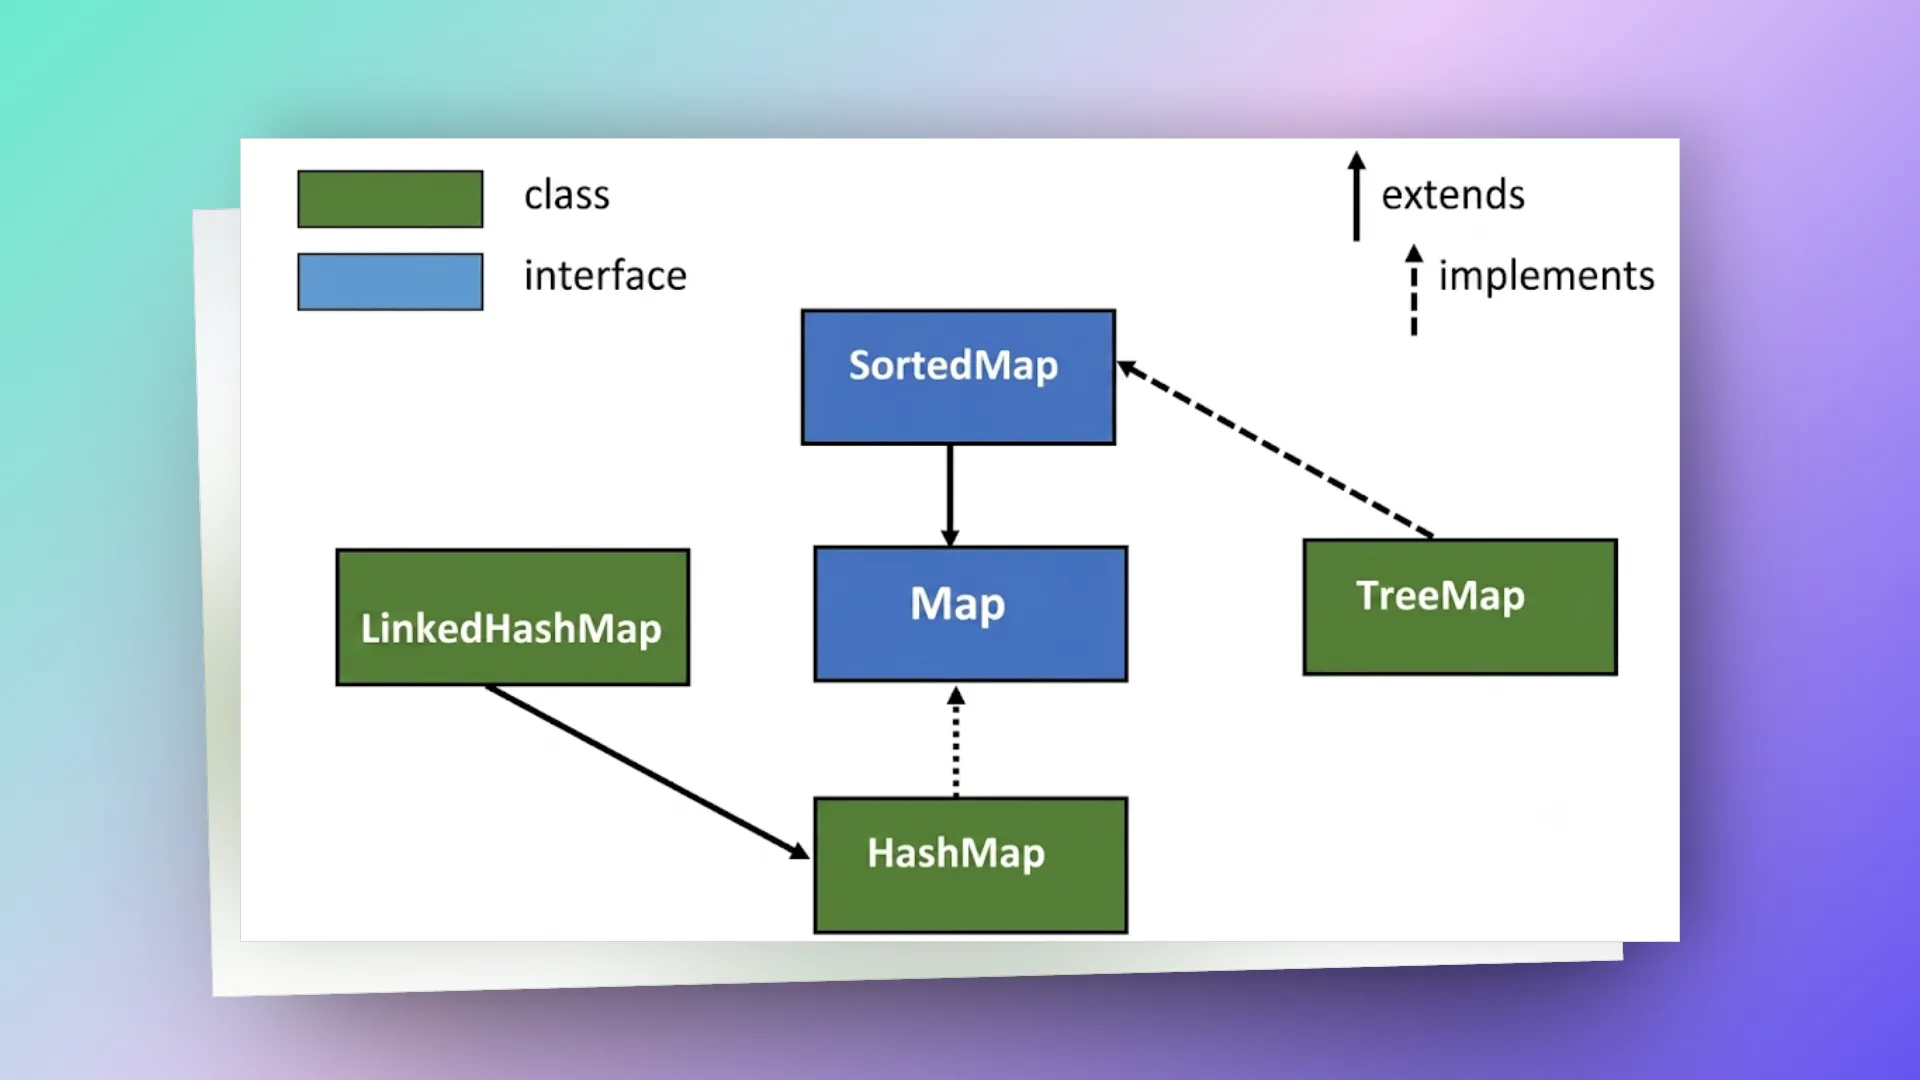
Gõ Map<String, Object> map = new HashMap<>() gần như đã thành phản xạ của dân Java. Nhưng với hệ thống phân tán hay ứng dụng cần hiệu năng cao, chọn cấu trúc dữ liệu cho có thì rất dễ tự tạo ra nút thắt về bộ nhớ và CPU.
Biết dùng thôi chưa đủ, phải hiểu nó chạy thế nào bên dưới (under the hood) thì mới chủ động được. Bài này mình mổ xẻ các implementation của Map Interface trong Java, từ cấu trúc bên trong tới mấy pattern hay dùng khi code.
# map interface
Map lưu dữ liệu theo cặp Key-Value, mỗi Key là duy nhất và trỏ tới đúng một Value. Tuỳ bạn cần tra nhanh, cần giữ thứ tự hay cần an toàn khi chạy đa luồng, Java có sẵn từng (implementations) riêng:
- HashMap: time complexity
O(1), không giữ thứ tự nhưng cho phépnull. - LinkedHashMap: kế thừa
HashMap, giữ thứ tự thêm vào hoặc thứ tự truy cập (hợp để làmLRU Cache). - TreeMap: dựa trên
Red-Black Tree, time complexityO(logn), tự sắp xếp theokey. - ConcurrentHashMap: dành cho đa luồng, khoá theo từng phần nhỏ (
segmented locking/node-level locking). - WeakHashMap: hợp tác tốt với
Garbage Collector, entry tự được dọn khi key không còn ai dùng. - EnumMap: nhanh nhất khi
Keylà hằng sốEnum. - IdentityHashMap: so sánh
Keybằng địa chỉ vùng nhớ chứ không so giá trị.
# HashMap
HashMap được dùng nhiều nhất, nhưng từ Java 8 trở đi nó cũng là thằng có bên trong phức tạp nhất. Về bản chất, nó là mảng (Array of Buckets) kết hợp với danh sách liên kết (Linked List) và cây đỏ đen (Red-Black Tree).
# internal structure (java 8+)
HashMap giữ một mảng tham chiếu tới các Node. Mỗi ô trong mảng là một bucket, có thể là null, trỏ tới một Node (nút đầu của một danh sách liên kết) hoặc trỏ tới một TreeNode (gốc của một cây đỏ đen).
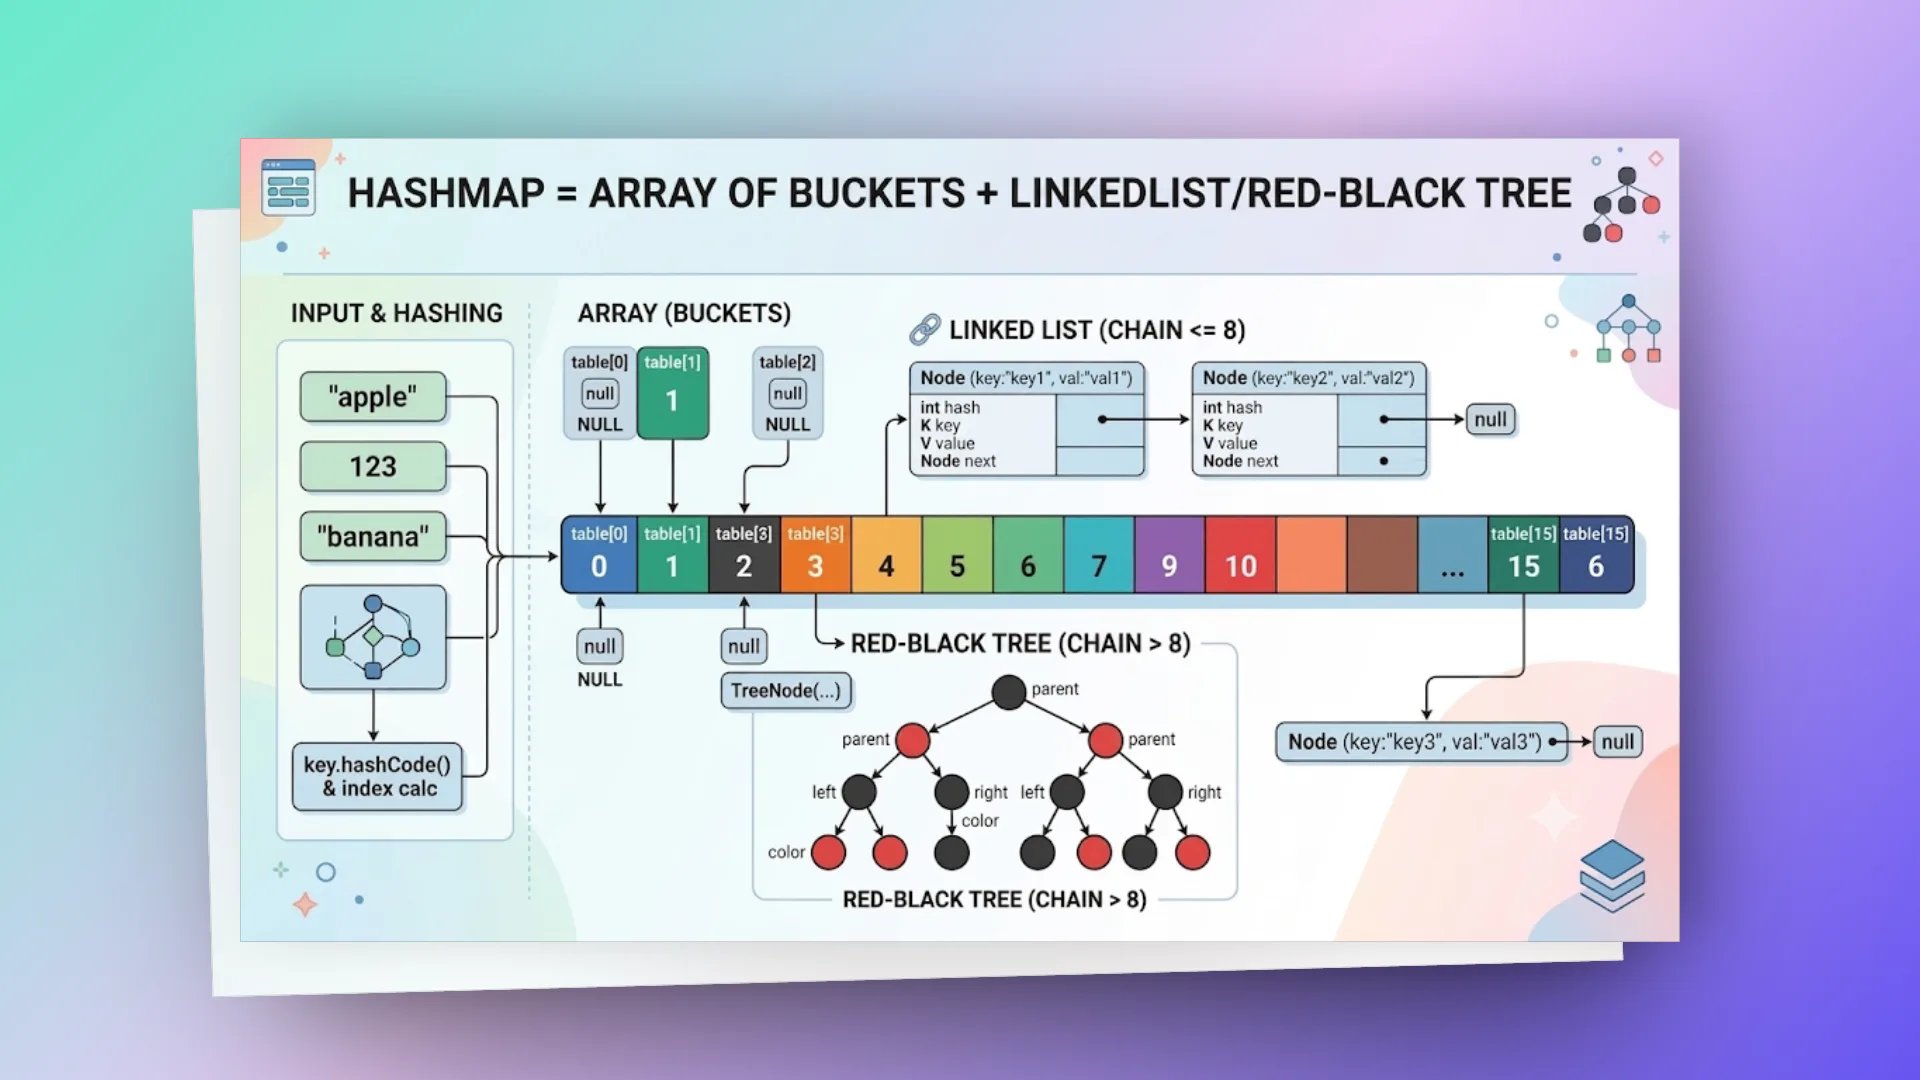
Nếu bucket đang là danh sách liên kết, mỗi Node có tham chiếu next trỏ tới nút kế tiếp. Chuỗi dài quá 8 thì danh sách này được đổi thành cây đỏ-đen, gồm các TreeNode (lớp này kế thừa từ Node).
# cách put() hoạt động
Khi put dữ liệu vào Map, mọi thứ diễn ra theo mấy bước khá rõ ràng:
- Tính hash: Java không xài thẳng
hashCode()của object. Hàmhash()lấy các bit caoXORvới các bit thấp củahashCodecho phân bố đều hơn, bớt đụng độ(collision)khiMapcòn nhỏ. - Tìm index: vị trí
buckettính bằngbitwise AND (capacity - 1) & hash. Phép này rẻ CPU hơn nhiều so với chia lấy dư%. - Xử lý đụng độ:
buckettrống thì tạoNodemới. Có dữ liệu rồi thì soKey. Trùng (theoequals()) thì cập nhậtValue, không trùng thì nốiNodemới vào cuối danh sách.
# Treeification & resize
Hiệu năng tụt khi có nhiều Key dồn vào cùng một bucket. Java 8 xử lý chuyện này bằng Treeification:
- Ngưỡng treeify (8 nodes): danh sách liên kết vượt quá
8phần tử (TREEIFY_THRESHOLD = 8) thì đổi sangRed-Black Tree, độ phức tạp giảm từO(n)xuốngO(log n). Có một điều kiện đi kèm: mảng phải có ít nhất64bucket (MIN_TREEIFY_CAPACITY). Mảng còn nhỏ hơn thìHashMapchọn cách resize (nhân đôi mảng) thay vì dựng cây, vì lúc đó chuỗi dài thường do mảng chật chứ chưa chắc do hash xấu. - Ngưỡng untreeify (6 nodes): khi resize tách một cây ra mà phần còn lại chỉ còn
6phần tử trở xuống thì quay về danh sách liên kết, khỏi tốn công duy trì cây. Ngưỡng lên là 8 mà ngưỡng xuống là 6 để map không bị đổi qua đổi lại liên tục khi số phần tử dao động quanh một mốc. - Rehashing: số phần tử vượt
capacity * loadFactor(mặc định16 * 0.75 = 12) thìHashMapnhân đôi kích thước mảng và phải chuyển toàn bộ entry sang mảng mới, một tác vụO(n). Từ Java 8, nó không tính lại hash mà chỉ xem thêm đúng một bit (hash & oldCap) để biết entry ở lại vị trí cũ hay dời sangvị trí cũ + oldCap, nhưng vẫn phải đi qua từng entry. → Best practice: ước lượng được số phần tử thì cứ khởi tạo sẵn. Để ýnew HashMap<>(n)nhận vào capacity chứ không phải số phần tử: muốn chứa1000phần tử mà không resize thì cần capacity khoảng1000 / 0.75 ≈ 1334. Từ Java 19 có sẵnHashMap.newHashMap(1000)tính giùm chuyện này.
# key properties
// QUAN TRỌNG: key phải override cả hashCode() VÀ equals()
// Nếu không → 2 objects "equal" nhưng khác bucket → duplicate keys!

// Contract:
// 1. equals() = true → hashCode() PHẢI bằng nhau
// 2. hashCode() bằng nhau → equals() KHÔNG nhất thiết true (collision OK)
// 3. hashCode() phải consistent (cùng object → cùng hash)
# complexity
| Operation | Average | Worst (all collisions) |
|---|---|---|
| put() | O(1) | O(log n) (tree) / O(n) (list, Java 7) |
| get() | O(1) | O(log n) |
| remove() | O(1) | O(log n) |
| containsKey() | O(1) | O(log n) |
| containsValue() | O(n) | O(n) |
Cột worst case O(log n) chỉ đúng khi bucket đã thành cây và key implement Comparable. Nếu nhiều key trùng hash mà không so sánh được với nhau, cây phải tìm cả hai nhánh, có thể tụt về O(n).
# null handling
- 1 null key allowed (luôn ở bucket 0)
- Multiple null values allowed
# LinkedHashMap
LinkedHashMap giữ thêm một danh sách liên kết đôi nối tất cả entry, nên duyệt ra đúng thứ tự lúc thêm vào. Hay hơn nữa, bật cờ accessOrder = true là nó thành cái LRU - Least Recently Used cache gần như có sẵn. Lưu ý ở chế độ này, get() cũng làm thay đổi cấu trúc (dời entry xuống cuối), nên dùng từ nhiều thread thì phải tự bọc đồng bộ; cache dùng chung trong production thường chọn thư viện như Caffeine.
// Insertion order (default)
Map<String, Integer> map = new LinkedHashMap<>();
map.put("c", 3);
map.put("a", 1);
map.put("b", 2);
// Iteration: c → a → b (insertion order)

// Access order (LRU cache)
Map<String, Integer> lru = new LinkedHashMap<>(16, 0.75f, true); // accessOrder=true
lru.put("a", 1);
lru.put("b", 2);
lru.put("c", 3);
lru.get("a"); // move "a" to tail
// Iteration: b → c → a (least recently used first)
# LRU cache implementation
public class LRUCache<K, V> extends LinkedHashMap<K, V> {
   private final int maxSize;

   public LRUCache(int maxSize) {
       super(maxSize, 0.75f, true); // accessOrder = true
       this.maxSize = maxSize;
   }

   @Override
   protected boolean removeEldestEntry(Map.Entry<K, V> eldest) {
       return size() > maxSize; // auto-remove oldest when full
   }
}
# TreeMap
TreeMap chạy trên Red-Black Tree, nên Key phải implement Comparable hoặc bạn phải đưa vào một Comparator riêng. Mấy thao tác CRUD bình thường của nó chỉ O(log n), chẳng có gì nổi bật. Chỗ nó mạnh là truy vấn theo khoảng (Range Queries) như subMap(), headMap(), floorKey() hay ceilingKey().
TreeMap<String, Integer> map = new TreeMap<>();
map.put("banana", 2);
map.put("apple", 1);
map.put("cherry", 3);
// Iteration: apple → banana → cherry (natural order)

// Custom comparator
TreeMap<String, Integer> desc = new TreeMap<>(Comparator.reverseOrder());

// Navigation methods
map.firstKey();               // "apple"
map.lastKey();                // "cherry"
map.lowerKey("banana");       // "apple" (strictly less)
map.floorKey("banana");       // "banana" (less or equal)
map.ceilingKey("b");          // "banana" (greater or equal)
map.higherKey("banana");      // "cherry" (strictly greater)
map.subMap("apple", "cherry"); // [apple, banana) — exclusive end
map.headMap("cherry");        // [apple, banana]
map.tailMap("banana");        // [banana, cherry]
# complexity
| Operation | Complexity |
|---|---|
| put/get/remove | O(log n) |
| firstKey/lastKey | O(log n) |
| subMap/headMap/tailMap | O(1) tạo view, O(log n + k) khi duyệt k phần tử |
# khi nào dùng TreeMap
- Cần key được sắp xếp
- Cần range query (subMap, headMap, tailMap)
- Cần tìm lân cận (floor, ceiling, lower, higher)
- KHÔNG dùng khi chỉ cần tra O(1) → dùng HashMap
# ConcurrentHashMap
Chạy đa luồng (multi-threading) mà dùng Collections.synchronizedMap() thì khá chắp vá và chậm, vì nó khoá (lock) nguyên cả object bằng một cái khoá duy nhất.
ConcurrentHashMap xử lý khéo hơn bằng cách chia nhỏ phạm vi khoá:
- Java 7: chia Map thành
16 segments, mỗisegmentcó khoá riêng. - Java 8+: đi thêm một bước với
Node-level locking, dùng lệnhCompare-And-Swap (CAS)kết hợp vớisynchronizedchỉ trên node đầu của từngbucket. Các(threads)khác nhau ghi đồng thời được miễn là dữ liệu rơi vào cácbucketkhác nhau.
# java 8+ internal
Cơ chế (Java 7): chia bảng băm thành nhiều Segment (mặc định 16). Mỗi Segment giống một bảng băm nhỏ, có Lock riêng (ReentrantLock). Thread nào ghi vào bucket cùng một Segment thì vẫn phải chờ nhau. Riêng thao tác đọc (get) ở cả Java 7 lẫn Java 8+ gần như không cần khoá, nhờ các field được khai báo volatile.
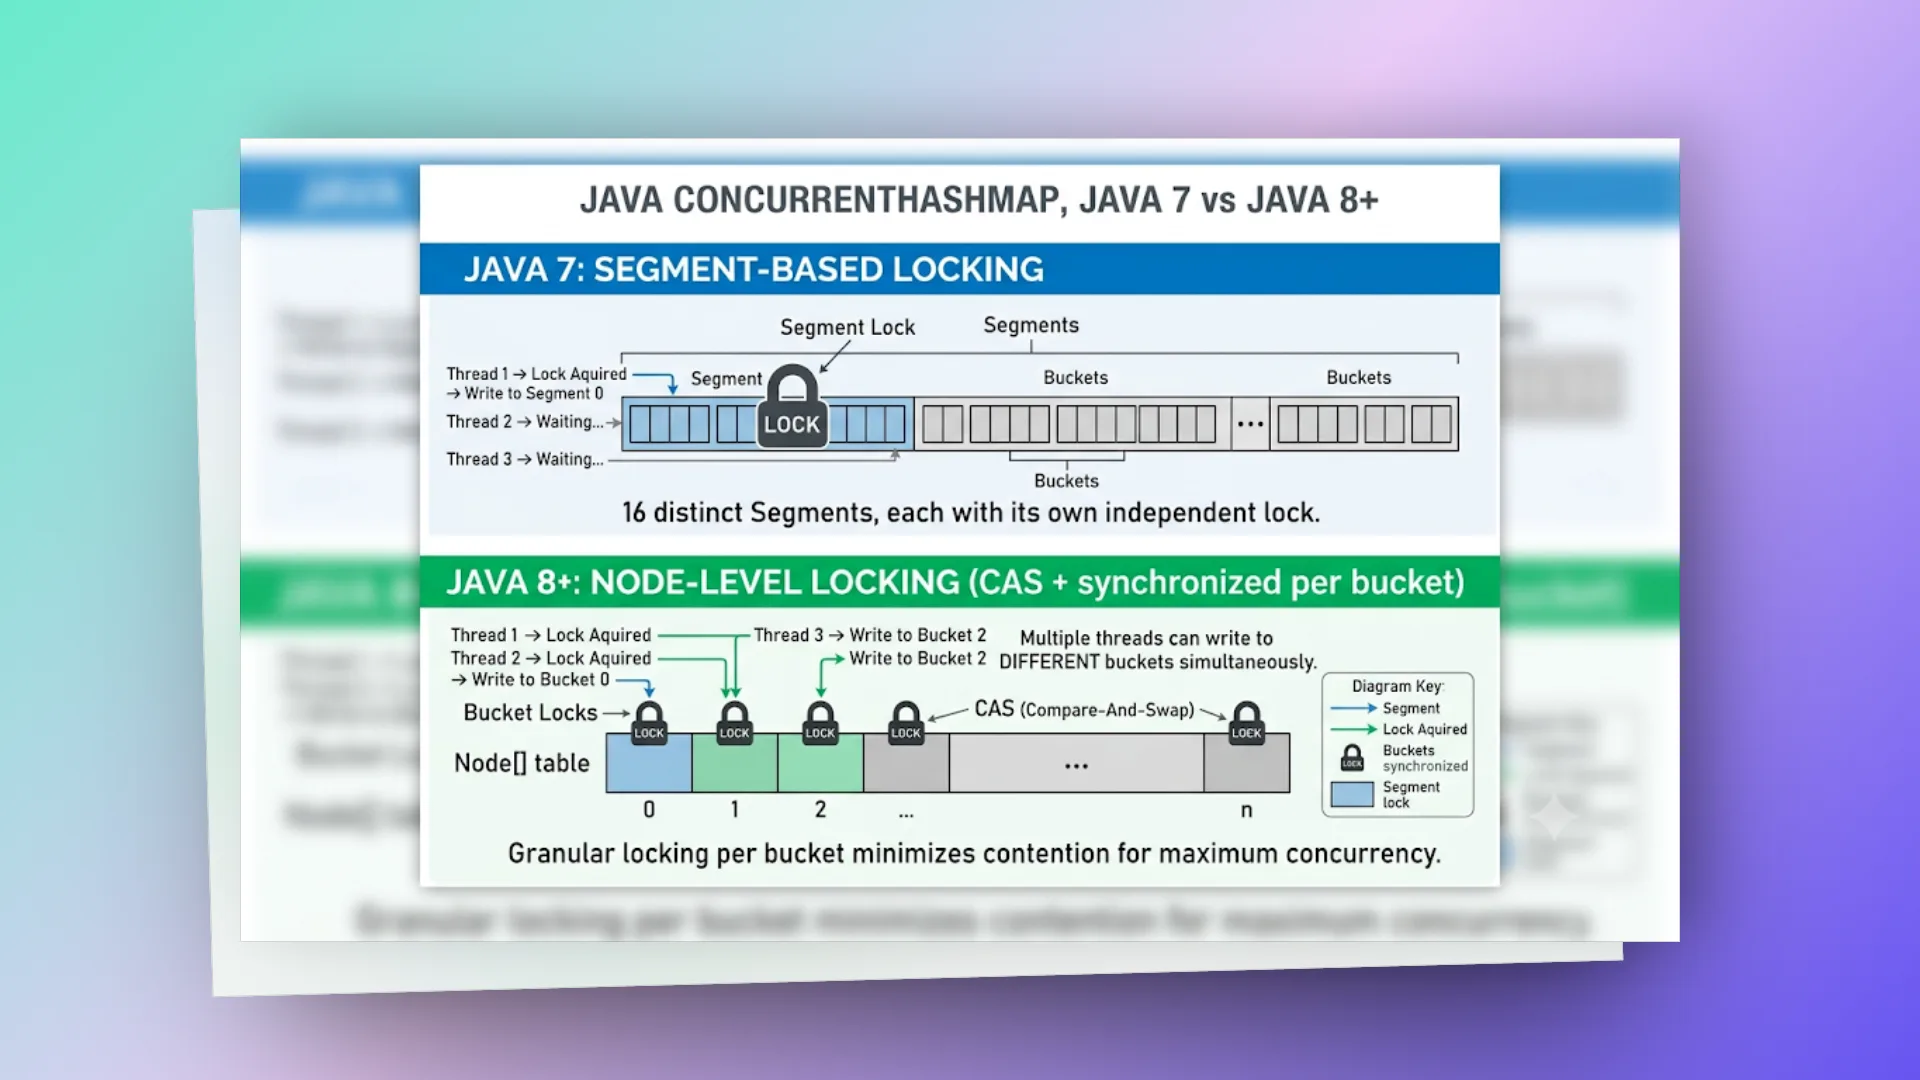
Java 8+: Node-Level Locking (Khóa theo từng Bucket)
Cơ chế: bỏ hẳn lớp Segment. bucket trống thì dùng CAS (Compare-And-Swap), còn có va chạm (collision) thì synchronized thẳng trên Node đầu của bucket đó → các thread ghi đồng thời vào các bucket khác nhau (table[0], table[1],...) mà không chặn nhau chút nào!
Vậy hiệu năng khác nhau chỗ nào?
- Java 7: khoá ở mức
Segment(Lock Granularity). Cấu hình16 segmentsthì cùng lúc tối đa16 threadsđược ghi. - Java 8+: khoá ở mức
Bucket(từng ô trong mảng). Mảng cỡ64,128hoặc lớn hơn thì số thread ghi cùng lúc cũng tăng theo, tranh khoá (lock contention) giảm hẳn.
# key differences vs HashMap
// KHÔNG cho phép null key hoặc null value (tránh ambiguity trong concurrent context)
concurrentMap.put(null, "value");  // NullPointerException!
concurrentMap.put("key", null);   // NullPointerException!

// Atomic operations
concurrentMap.putIfAbsent("key", "value");
concurrentMap.computeIfAbsent("key", k -> expensiveComputation(k));
concurrentMap.computeIfPresent("key", (k, v) -> v + 1);
concurrentMap.merge("key", 1, Integer::sum); // atomic increment
Một lưu ý với computeIfAbsent/compute: hàm truyền vào chạy trong lúc đang giữ khoá của bucket, nên phải ngắn và không được sửa chính map đó (gọi lồng computeIfAbsent trên cùng map). Từ Java 9, trường hợp gọi lồng thường bị phát hiện và ném IllegalStateException: Recursive update.
# atomic compound operations
// WRONG: check-then-act race condition
if (!map.containsKey(key)) {
   map.put(key, value); // another thread might put between check and put
}

// RIGHT: atomic
map.putIfAbsent(key, value);
map.computeIfAbsent(key, k -> createValue(k));
# vs Collections.synchronizedMap()
// synchronizedMap: wraps entire map with single mutex → poor concurrency
Map<K, V> syncMap = Collections.synchronizedMap(new HashMap<>());
// Mọi operation lock toàn bộ map → 1 thread tại 1 thời điểm

// ConcurrentHashMap: fine-grained locking → high concurrency
ConcurrentHashMap<K, V> concMap = new ConcurrentHashMap<>();
// Multiple threads đọc/ghi đồng thời (khác buckets)
# WeakHashMap
Keys là WeakReference. Khi key không còn strong reference nào → GC thu dọn → entry tự biến mất.
WeakHashMap<Object, String> cache = new WeakHashMap<>();
Object key = new Object();
cache.put(key, "data");

key = null; // no more strong reference to key
System.gc(); // GC may collect the key
// cache.size() có thể = 0 (entry bị remove)
Use case: cache mà không muốn cản GC dọn dẹp (metadata cache, classloader cache).
Hai cái bẫy hay gặp: value giữ tham chiếu mạnh ngược lại key thì entry không bao giờ được dọn; và key là String literal ("abc") hay giá trị được cache sẵn như Integer nhỏ thì luôn còn tham chiếu nên cũng không bao giờ biến mất. Entry chỉ thật sự bị gỡ khi map được truy cập lần sau, không phải ngay lúc GC chạy.
# EnumMap
Làm riêng cho key kiểu enum. Bên trong dùng array (index = enum ordinal).
enum Status { PENDING, ACTIVE, CLOSED }

EnumMap<Status, List<Order>> ordersByStatus = new EnumMap<>(Status.class);
ordersByStatus.put(Status.PENDING, pendingOrders);
ordersByStatus.put(Status.ACTIVE, activeOrders);- Nhanh hơn HashMap (truy cập array, không phải hash)
- Tiết kiệm bộ nhớ (không tạo Node object cho từng entry, chỉ một mảng value)
- Giữ đúng thứ tự khai báo enum
# IdentityHashMap
So key bằng == chứ không dùng equals(). Hash bằng System.identityHashCode() chứ không dùng hashCode().
IdentityHashMap<String, Integer> map = new IdentityHashMap<>();
String a = new String("hello");
String b = new String("hello");

map.put(a, 1);
map.put(b, 2);
map.size(); // 2! (a != b dù a.equals(b))
Use case: duyệt object graph (đánh dấu object đã đi qua), các framework serialization.
# so sánh tổng hợp
| Map | Order | Null Key | Null Value | Thread-safe | Complexity |
|---|---|---|---|---|---|
| HashMap | None | 1 | Multiple | No | O(1) |
| LinkedHashMap | Insertion/Access | 1 | Multiple | No | O(1) |
| TreeMap | Sorted (natural/comparator) | No | Multiple | No | O(log n) |
| Hashtable | None | No | No | Yes (slow) | O(1) |
| ConcurrentHashMap | None | No | No | Yes (fast) | O(1) |
| WeakHashMap | None | 1 | Multiple | No | O(1) |
| EnumMap | Enum declaration | No | Multiple | No | O(1) |
# common patterns
# frequency counting
Map<String, Integer> freq = new HashMap<>();
for (String word : words) {
   freq.merge(word, 1, Integer::sum);
}
# grouping
Map<String, List<Order>> byStatus = orders.stream()
   .collect(Collectors.groupingBy(Order::getStatus));
# compute pattern
// computeIfAbsent: lazy initialization
Map<String, List<String>> multimap = new HashMap<>();
multimap.computeIfAbsent("key", k -> new ArrayList<>()).add("value");
# immutable maps
// Java 9+
Map<String, Integer> map = Map.of("a", 1, "b", 2, "c", 3); // tối đa 10 cặp; null hoặc key trùng → exception
Map<String, Integer> map2 = Map.ofEntries(
   Map.entry("a", 1),
   Map.entry("b", 2)
);

// Unmodifiable view
Map<String, Integer> unmod = Collections.unmodifiableMap(originalMap);
# interview tips
- HashMap resize: capacity nhân đôi, rehash toàn bộ entry, O(n)
- HashMap vs Hashtable: khác ở chuyện null, synchronization, Hashtable là đồ legacy
- Contract của hashCode(): hai object equals thì BẮT BUỘC cùng hashCode
- ConcurrentHashMap: CAS + synchronized theo từng bucket (Java 8+)
- TreeMap: Red-Black tree, O(log n), có NavigableMap interface
- LinkedHashMap: làm LRU cache với removeEldestEntry()
- WeakHashMap: cache không cản GC, key là WeakReference
- Initial capacity: biết trước size thì set luôn (khỏi resize)
- Load factor 0.75: cân bằng giữa bộ nhớ và tốc độ
Phần lớn trường hợp HashMap vẫn là lựa chọn đúng. Chỉ cần nhớ mấy tình huống đổi sang loại khác: cần thứ tự thì LinkedHashMap, cần sắp xếp hay tìm theo khoảng thì TreeMap, nhiều thread cùng ghi thì ConcurrentHashMap, key là enum thì EnumMap.
Chỉ là những ghi chép cá nhân với hy vọng mang lại chút giá trị. Nếu thấy hữu ích, đừng ngại chia sẻ cho bạn bè & đồng nghiệp nhé!
Happy coding 😎 👍🏻 🚀 🔥.