acid in sql
Tung Bui Thanh (TungDaDev)12 mins read
Làm dev thì chắc ai cũng từng đau đầu vì mấy bug dữ liệu bị sai lệch, mất mát hay deadlock khi nhiều người dùng cùng lúc. Nguyên nhân thường nằm ở chỗ quản lý transaction chưa chuẩn.
Bài này là cuốn sổ tay mình ghi lại, tập trung vào ACID, isolation level, locking và cách áp dụng với Spring Data JPA. Mong là đọc xong các bạn sẽ tự tin hơn khi làm việc với database!
# acid properties
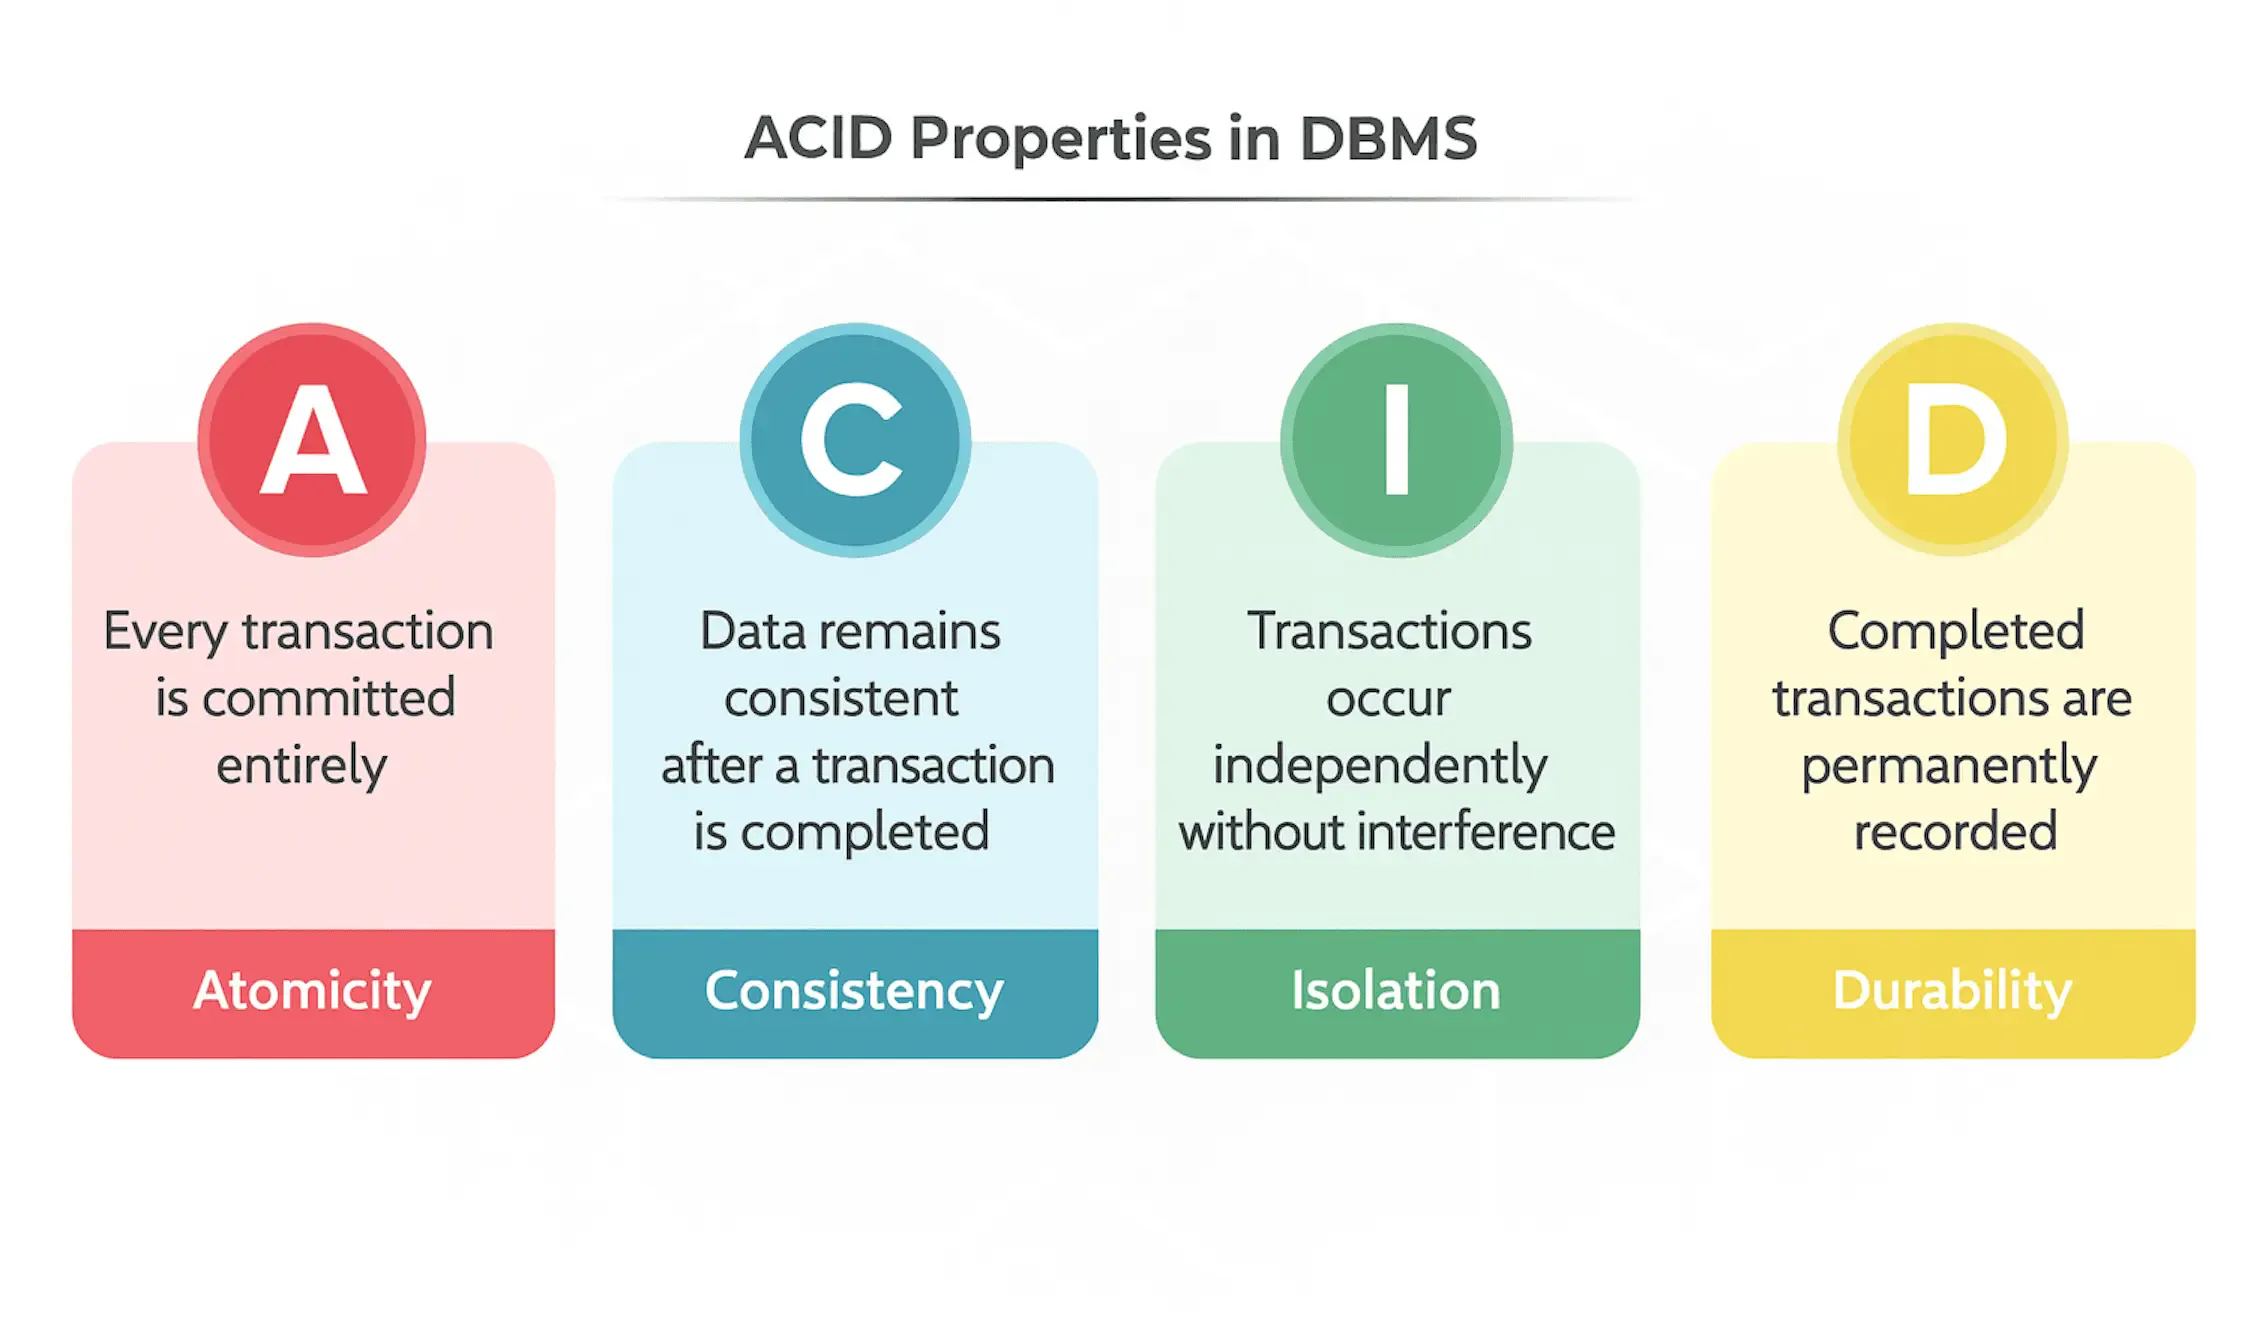
Để dữ liệu luôn toàn vẹn, một transaction trong database cần đảm bảo 4 tính chất (ACID):
# atomicity - tính nguyên tử ~~ "cùng sống hoặc cùng chết"
Transaction là một khối "all-or-nothing". Mọi thao tác bên trong phải thành công hết, chỉ cần một chỗ lỗi là tất cả phải rollback về trạng thái ban đầu.
BEGIN;
 UPDATE accounts SET balance = balance - 1000 WHERE id = 'A';
 UPDATE accounts SET balance = balance + 1000 WHERE id = 'B';
COMMIT;
-- Nếu lệnh thứ 2 thất bại, cả transaction bị huỷ, lệnh thứ 1 cũng rollback để A không bị trừ tiền oan.
-- PostgreSQL: lệnh lỗi làm transaction bị abort, COMMIT phía sau sẽ thành ROLLBACK.
-- MySQL: lệnh lỗi KHÔNG tự rollback cả transaction, ứng dụng phải chủ động gọi ROLLBACK.
# consistency - tính nhất quán ~~ "trước sau như một"
Transaction đưa database từ một trạng thái hợp lệ sang một trạng thái hợp lệ khác. Khi transaction kết thúc, mọi ràng buộc (Constraints, FK, UNIQUE, NOT NULL...) và business rule đều phải được thoả. Database chỉ tự kiểm được phần ràng buộc đã khai báo; còn business rule (ví dụ tổng tiền hai tài khoản trước và sau chuyển khoản phải bằng nhau) là trách nhiệm của code ứng dụng, A, I, D chỉ là công cụ giúp giữ nó.
-- Ràng buộc: balance >= 0
BEGIN;
 UPDATE accounts SET balance = balance - 5000 WHERE id = 'A';
 -- Nếu A chỉ có 3000 -> Vi phạm CHECK constraint -> Transaction rollback ngay.
COMMIT;
# isolation - tính cách ly - "việc ai nấy làm"
Khi nhiều transaction chạy song song (concurrent), chúng không được nhìn thấy trạng thái dở dang của nhau. Chọn mức cách ly (isolation level) nào là chọn cách đánh đổi (trade-off) giữa độ an toàn của dữ liệu và hiệu năng.
# durability - tính bền vững - "đã chốt là ghi sổ"
Một khi transaction đã COMMIT thành công thì dữ liệu được giữ an toàn, kể cả khi hệ thống crash hay mất điện. Các database thường dùng WAL (Write-Ahead Logging) để lo vụ này: thay đổi được ghi vào log và flush xuống đĩa trước khi báo COMMIT thành công, sập nguồn thì lúc khởi động lại database đọc log để dựng lại dữ liệu. (Các tuỳ chọn như synchronous_commit = off của PostgreSQL đổi một phần độ bền này lấy tốc độ.)
# isolation levels: kiểm soát chạy song song
Khi các transaction chạy song song mà cách ly không tốt, hệ thống dễ gặp mấy "hiện tượng lạ" (read anomalies).
Các kiểu đọc bất thường:
- Dirty Read: đọc phải dữ liệu chưa commit của transaction khác (rất rủi ro, vì transaction kia có thể rollback).
- Non-Repeatable Read: trong cùng một transaction, đọc một dòng (row) 2 lần lại ra 2 kết quả khác nhau (do transaction khác chen vào update).
- Phantom Read: cùng một câu query (ví dụ COUNT), chạy 2 lần ra số lượng khác nhau (do transaction khác vừa insert/delete thêm data).
- Serialization Anomaly: kết quả khi chạy song song không khớp với kết quả khi chạy lần lượt từng cái.
# isolation levels (theo postgresql)
| Level | Dirty Read | Non-Repeatable Read | Phantom Read | Serialization Anomaly |
|---|---|---|---|---|
| READ UNCOMMITTED* | Không (PG chạy như READ COMMITTED) | Có thể | Có thể | Có thể |
| READ COMMITTED (default) | Không | Có thể | Có thể | Có thể |
| REPEATABLE READ | Không | Không | Không (PG) | Có thể |
| SERIALIZABLE | Không | Không | Không | Không |
Lưu ý: PostgreSQL không thật sự implement READ UNCOMMITTED. Cấu hình mức này thì nó tự chạy như READ COMMITTED. Bảng trên là hành vi của PostgreSQL; chuẩn SQL chỉ quy định mức tối thiểu (ví dụ chuẩn vẫn cho phép phantom read ở REPEATABLE READ), mỗi database implement một kiểu, nên đổi database thì phải đọc lại tài liệu của nó.
Giờ đi vào từng mức cách ly hay dùng:
# read committed (cân bằng, phổ biến nhất)
- Đặc điểm: mỗi câu query thấy một "snapshot" dữ liệu tại thời điểm câu đó bắt đầu chạy. Đây là mức mặc định của PostgreSQL, Oracle và SQL Server (MySQL InnoDB mặc định là REPEATABLE READ).
- Use case: an toàn cho hầu hết thao tác
CRUDbình thường, hiệu năng cao.
# repeatable read (nhất quán suốt transaction)
- Đặc điểm: snapshot dữ liệu được chốt từ câu lệnh đầu tiên của transaction (với PostgreSQL là câu đầu tiên, không phải lúc
BEGIN). Nếu transaction khác đã update và commit cùng dòng dữ liệu mà mình định update, PostgreSQL báo lỗicould not serialize access due to concurrent update. - Use case: hợp với tính toán tài chính, chốt số dư cuối ngày. Phía ứng dụng cần có logic retry (thử lại) khi gặp conflict.
- Lưu ý: hành vi trên là của PostgreSQL. MySQL InnoDB cũng mặc định REPEATABLE READ nhưng không báo lỗi khi đụng độ: câu UPDATE đọc bản mới nhất đã commit rồi ghi đè, nên vẫn có thể dính lost update nếu đọc bằng SELECT thường rồi tính toán ở ứng dụng. Với MySQL, cần
SELECT ... FOR UPDATEhoặc optimistic locking.
# serializable (khắt khe nhất)
- Đặc điểm: PostgreSQL dùng
SSI (Serializable Snapshot Isolation): không khoá chặn mà theo dõi phụ thuộc đọc/ghi giữa các transaction, thấy nguy cơ sai thì huỷ một bên với lỗicould not serialize access. Kết quả y hệt như bắt các transaction xếp hàng chạy từng cái một. (MySQL InnoDB thì làm khác: biến mọi SELECT thường thànhSELECT ... FOR SHARE, tức là dùng khoá.) - Use case: thống kê phức tạp, tính aggregate rồi dựa vào đó để ghi data.
Throughputthấp nhất và bắt buộc phải có retry.
# locking strategies: các kiểu khoá dữ liệu
# optimistic locking (khoá lạc quan, ở tầng application)
Dựa trên niềm tin là "hiếm khi có conflict". Không khoá data ngay, chỉ kiểm tra data có bị ai đổi chưa vào lúc lưu (thường dùng cột version).
@Entity
public class Product {
   @Id
   private UUID id;

   @Version  // JPA quản lý version tự động
   private Long version;
   // ...
}
Khi lưu, Hibernate chạy UPDATE ... SET ..., version = version + 1 WHERE id = ? AND version = ?. Nếu không dòng nào được update (ai đó đã đổi version trước), nó ném OptimisticLockException (Spring bọc thành ObjectOptimisticLockingFailureException), ứng dụng bắt lỗi này để retry hoặc báo người dùng tải lại dữ liệu.
→ Hợp với hệ thống Read-heavy (đọc nhiều), ít khi ghi đè cùng một record, chấp nhận được retry.
# pessimistic locking (khoá bi quan, ở tầng database)
Khoá cứng dòng dữ liệu (row) ngay lúc đọc bằng SELECT ... FOR UPDATE. Transaction khác muốn đụng vào dòng này thì phải đứng chờ.
@Query("SELECT p FROM Product p WHERE p.id = :id")
@Lock(LockModeType.PESSIMISTIC_WRITE)
Optional<Product> findByIdForUpdate(@Param("id") UUID id);
→ Hợp với hệ thống Write-heavy (ghi nhiều), tranh chấp cao như trừ tiền ví điện tử, giảm tồn kho. Method này phải được gọi bên trong một transaction (lock giữ tới lúc commit/rollback). Nhớ giữ transaction thật ngắn để tránh deadlock, và cân nhắc đặt lock timeout (hint jakarta.persistence.lock.timeout) để khỏi chờ vô hạn.
# @Transactional trong spring
Spring làm chuyện quản lý transaction "trong suốt" và nhàn hơn nhiều. Có điều dùng sai thì hậu quả khó lường.
Cấu hình cơ bản:
@Transactional(
    propagation = Propagation.REQUIRED,    // Mặc định: Join vào transaction hiện tại hoặc tạo mới
    isolation = Isolation.READ_COMMITTED,  // Mức độ cách ly
    rollbackFor = Exception.class,         // Rollback cho mọi loại Exception (Mặc định chỉ rollback RuntimeException và Error)
    timeout = 5                            // Timeout sau 5 giây
)

public void transfer(UUID fromId, UUID toId, BigDecimal amount) { ... }
Mấy cái bẫy hay gặp khi dùng @Transactional:
# lỗi self-invocation (bypass proxy)
Gọi một method @Transactional từ method khác trong cùng class thì Spring Proxy bị đi vòng qua, transaction context bị bỏ qua luôn.
@Service
public class OrderService {
   public void processOrder(Order order) { // <--- Hàm này gọi
       save(order);
       sendNotification(order);
   }

   @Transactional(propagation = Propagation.REQUIRES_NEW)
   public void sendNotification(Order order) {
       // Thất bại! Do được gọi từ processOrder cùng class, REQUIRES_NEW bị phớt lờ.
   }
}
→ Cách fix: tách sendNotification sang một class Service khác. Nguyên nhân là @Transactional chạy qua proxy bọc ngoài bean; lời gọi this.sendNotification() đi thẳng vào object thật, không qua proxy. Cách khác là dùng TransactionTemplate để mở transaction bằng code ngay tại chỗ.
# lỗi LazyInitializationException
Truy cập một thuộc tính Lazy load (như list con) khi đã ra khỏi block @Transactional.
→ Cách fix: dùng @EntityGraph, JOIN FETCH trong JPQL, hoặc đảm bảo đã lấy data ngay trong scope của transaction.
Spring Boot mặc định bật spring.jpa.open-in-view=true (và in cảnh báo lúc khởi động), giữ session mở suốt request nên lỗi này hay bị che đi ở tầng controller, đổi lại là connection bị giữ lâu hơn và query lazy chạy ngầm khi serialize JSON. Nhiều team tắt nó đi để lỗi lộ ra sớm.
# ôm đồ quá nặng (long transactions)
Gọi I/O (như gọi API ngoài, đọc ghi file) bên trong block @Transactional. Làm vậy là giữ connection database quá lâu, Connection Pool cạn sạch.
→ Cách fix: chuẩn bị hết dữ liệu (đọc file, gọi API) ở ngoài, chỉ đưa phần Insert/Update vào trong transaction (thường đi kèm xử lý batch).
# mấy pattern nâng cao (advanced patterns)
# xử lý tận gốc lỗi n+1 query
N+1 là thứ âm thầm giết hiệu năng. Query ra 1 list đơn hàng, rồi loop qua từng đơn để lấy chi tiết, thế là sinh thêm N câu query.
Cách xử lý:
- JPQL:
SELECT o FROM Order o JOIN FETCH o.items(cẩn thận khi kết hợp với phân trang: Hibernate không giới hạn được bằng SQL mà kéo hết về rồi cắt trong bộ nhớ, kèm cảnh báo HHH000104 ở Hibernate 5, HHH90003004 ở Hibernate 6 trở lên) - Annotation: gắn
@EntityGraph(attributePaths = {"items"})lên hàm lấy data. - Hibernate: dùng
@BatchSizeđể gom các lần fetch lại.
# chủ động chống deadlock
Deadlock xảy ra khi transaction 1 giữ lock A và chờ lock B, trong khi transaction 2 giữ lock B và chờ lock A.
- Lock ordering: luôn sắp xếp thứ tự xử lý dữ liệu (ví dụ sort
User IDtừ nhỏ đến lớn) trước khi lock. - Retry pattern: bọc hàm xử lý bằng
@Retryable(thư viện Spring Retry, hoặcorg.springframework.resiliencecó sẵn từ Spring Framework 7) để tự chạy lại khi gặp lỗi deadlock (Spring dịch thànhCannotAcquireLockException/PessimisticLockingFailureException). Retry phải nằm ngoài transaction: transaction bị chọn làm nạn nhân deadlock đã rollback, retry bên trong nó là vô nghĩa, phải mở transaction mới.
# dùng database làm hàng đợi (skip locked)
Với task đơn giản, thay vì dựng RabbitMQ/Kafka, có thể dùng luôn PostgreSQL (hoặc MySQL 8.0+) làm queue. Để các worker khỏi giành nhau 1 record thì dùng SKIP LOCKED. Câu lệnh phải chạy trong transaction: worker lấy task, xử lý, cập nhật status rồi commit thì lock mới được nhả; worker chết giữa chừng thì transaction rollback và task tự quay về hàng đợi. Cách này giữ transaction (và connection) suốt lúc xử lý; task chạy lâu thì nên chuyển status sang PROCESSING rồi commit ngay, kèm thời hạn để task bị treo được nhặt lại.
-- Lấy task đầu tiên đang PENDING, bỏ qua các task đang bị worker khác khóa
SELECT * FROM tasks WHERE status = 'PENDING' ORDER BY created_at LIMIT 1 FOR UPDATE SKIP LOCKED;
# decision matrix
Cho dễ nhớ, đây là bảng tóm tắt khi nào dùng cái gì:
| Scenario | Isolation | Locking | Retry |
|---|---|---|---|
| Simple CRUD | READ COMMITTED | None | No |
| Balance check + update | REPEATABLE READ | Pessimistic (FOR UPDATE) | Yes |
| Inventory decrement | READ COMMITTED | Pessimistic (FOR UPDATE) | Yes |
| Report generation | REPEATABLE READ | None (read-only) | No |
| Concurrent queue workers | READ COMMITTED | SKIP LOCKED | No |
| End-of-day batch | SERIALIZABLE | None | Yes (mandatory) |
| User form save | READ COMMITTED | Optimistic (@Version) | Yes (user retry) |
| Aggregate + write result | SERIALIZABLE | None | Yes |
Chỉ là những ghi chép cá nhân với hy vọng mang lại chút giá trị. Nếu thấy hữu ích, đừng ngại chia sẻ cho bạn bè & đồng nghiệp nhé!
Happy coding 😎 👍🏻 🚀 🔥.